
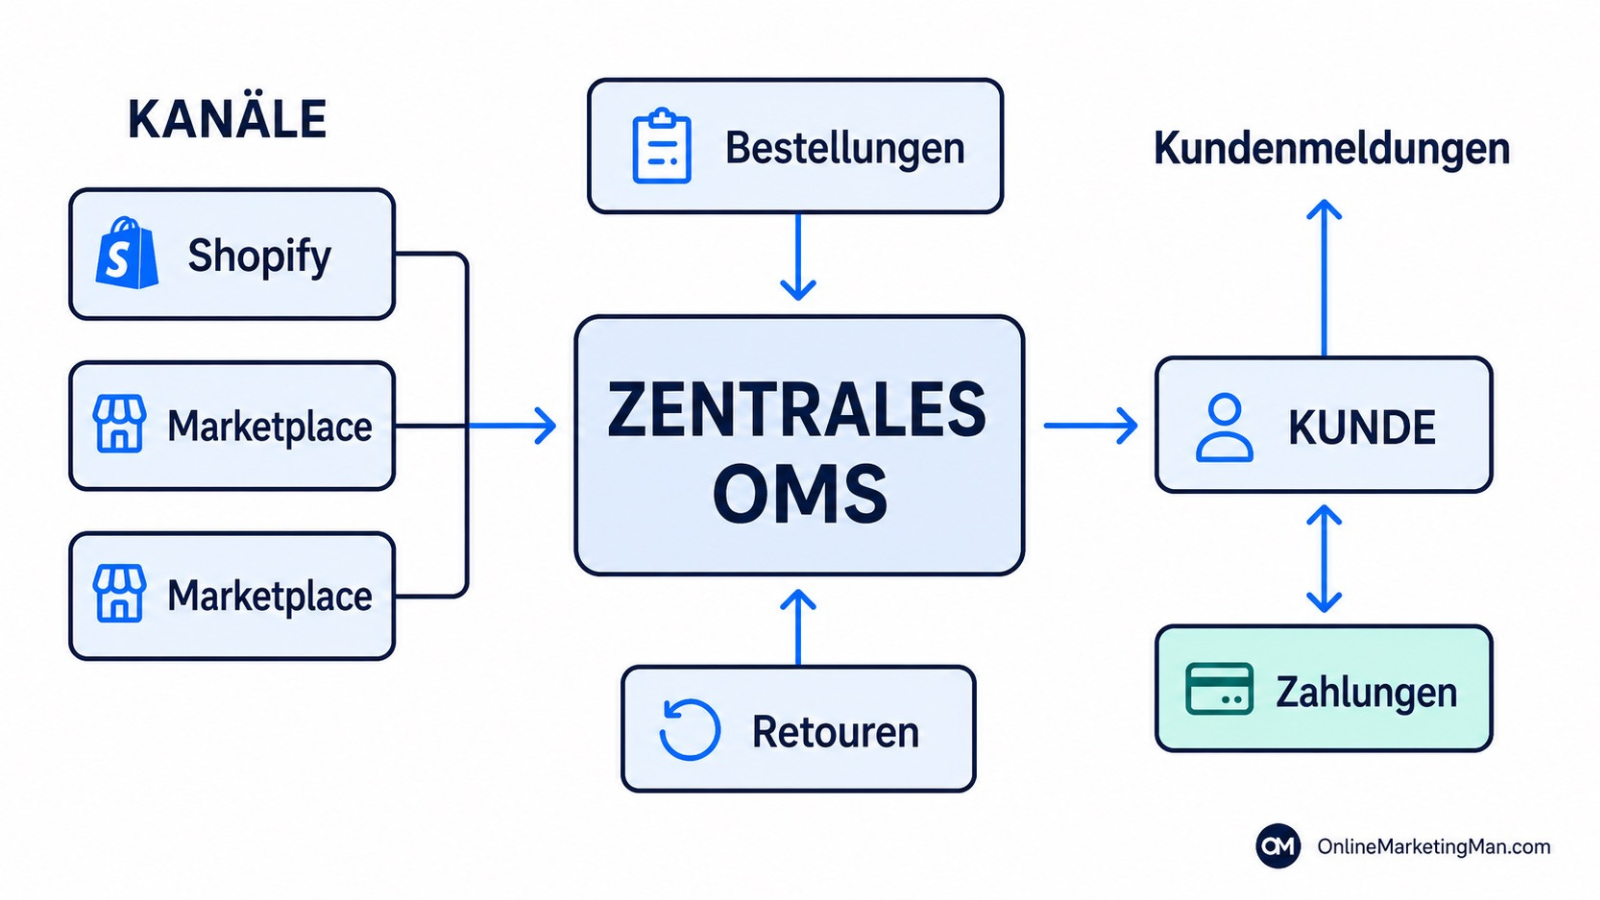
Order- und Retourenorchestrierung ohne Chaos: ein OMS-Flow für alle Kanäle
Wenn Bestellungen aus Shopify, Marktplätzen und dem stationären Handel in einer operativen Kette zusammenlaufen, entsteht Komplexität nicht allein durch das Volumen. Der eigentliche Druck entsteht, weil jeder Kanal ein eigenes Datenmodell, eigene Statuswerte, Servicelevel und Retourenregeln verwendet. Doppelte Tickets, verspätete Lieferungen, widersprüchliche Bestandsinformationen und administrativ ungeklärte Retouren sind deshalb keine isolierten Vorfälle. Sie zeigen, dass die Organisation zwar mehrere Systeme verbunden hat, die Entscheidungen zwischen diesen Systemen aber noch nicht zentral steuert.
Eine schlanke Order-Management-System-Schicht, kurz OMS-Schicht, beseitigt diese Fragmentierung, ohne ERP, Commerce-Plattform oder WMS zu ersetzen. Sie normalisiert Events, wendet zentrale Routing- und Retourenregeln an und veröffentlicht Entscheidungen in allen beteiligten Systemen. Damit wird das OMS nicht zu einer weiteren administrativen Anwendung, sondern zur Orchestrierungsschicht für Geschwindigkeit, Zuverlässigkeit und kommerzielle Kontrolle. Ziel ist nicht mehr Technologie, sondern ein durchgängig nachvollziehbarer Order- und Retourenflow, der Skalierung ermöglicht, ohne dass die Komplexität schneller wächst als der Umsatz.
Warum ERP und Commerce-Plattformen dies nicht eigenständig lösen können
ERP, Commerce-Plattformen und Fulfillment-Systeme wurden jeweils für eine eigene Kernfunktion entwickelt. Das ERP sichert die finanzielle und administrative Korrektheit, Shopify oder ein Marktplatz erfasst die kommerzielle Transaktion und das WMS oder der 3PL-Dienstleister führt das physische Fulfillment aus. Keines dieser Systeme besitzt automatisch einen vollständigen Überblick über sämtliche Kanalregeln, verfügbare Bestandsstandorte, Kundenzusagen und Ausnahmen. Wird die Orchestrierung in eines dieser Systeme hineingezwungen, verknüpft sich seine Kernfunktion mit einer Logik, die sich fortlaufend ändern muss.
Daraus entstehen drei strukturelle Spannungsfelder. Kanaldatenmodelle verwenden unterschiedliche Felder und Statusdefinitionen, Fulfillment-Standorte arbeiten mit eigenen Cut-off-Zeiten und Serviceleveln, und die Retourenbedingungen unterscheiden sich je nach Markt oder Verkaufsplattform. Ohne zentrale Schicht werden diese Unterschiede in separaten Integrationen gelöst. Dieselbe Regel wird anschließend an mehreren Stellen gepflegt, sodass eine kleine Änderung unerwartete Auswirkungen auf Bestand, Kundenkommunikation und finanzielle Verarbeitung haben kann. Skalierung erhöht dann nicht nur das Volumen, sondern auch die Zahl gegenseitiger Abhängigkeiten.
Aufgabenverteilung zwischen Kernsystemen und OMS-Schicht
Der folgende Vergleich zeigt, wo die Verantwortung bestehender Systeme endet und die zentrale Orchestrierung beginnt. Das OMS übernimmt weder Buchhaltung noch Auftragserstellung oder Lagerausführung. Es verbindet diese Funktionen über eine Entscheidungsschicht, die Orders normalisiert, den Fulfillment-Pfad auswählt, Statuswerte harmonisiert und Ausnahmen nachvollziehbar macht. Gerade diese Abgrenzung verhindert, dass sich das OMS zu einem neuen monolithischen System entwickelt und damit dieselbe Unflexibilität erzeugt, die die Organisation eigentlich beseitigen wollte.
| Komponente | Primäre Verantwortung | Fehlende Steuerungsfunktion | Rolle des OMS |
|---|---|---|---|
| ERP | Buchhaltung, Bestandsverwaltung und finanzielle Verarbeitung | Kanalnormalisierung und dynamisches Fulfillment-Routing | Entscheidungen orchestrieren, ohne finanzielle Quelldaten zu duplizieren |
| Shopify oder Marktplatz | Auftragserstellung, Zahlung und kommerzielle Kundeninteraktion | SLA-Überwachung und standortübergreifende Auswahl | Bestimmen, wo und unter welchen Bedingungen das Fulfillment erfolgt |
| WMS oder 3PL | Bestandszuweisung, Picking, Packing und Versand | Zentrale Harmonisierung von Statuswerten und Ausnahmen | Ausführung steuern und einheitliche Statusupdates veröffentlichen |
| OMS-Schicht | Normalisierung, Routing, Statussynchronisierung und Retourenorchestrierung | Kein Ersatz für finanzielle oder physische Ausführung | Die gesamte Order- und Retourenkette zentral steuern |
Diese Aufgabenverteilung macht Architekturentscheidungen steuerbar. Das ERP bleibt die finanzielle Quelle, die Commerce-Plattform bleibt der Verkaufskanal und das WMS bleibt für die Lagerausführung verantwortlich. Das OMS verwaltet die Übergänge zwischen diesen Domänen und dokumentiert, warum eine Order an einen bestimmten Standort ging, warum sich ein Status änderte oder warum eine Retoure anders behandelt wurde. Dadurch lassen sich Regeln anpassen, ohne die Stabilität der Kernsysteme zu gefährden, und jede Abweichung kann über die gesamte Kette hinweg untersucht werden.
Der End-to-End-Orderflow als Steuerungsprozess
In einer ausgereiften Architektur beginnt jede Order als Event. Webhooks aus Shopify, Marktplätzen oder POS-Systemen werden nicht direkt an ein WMS gesendet, sondern zunächst durch das OMS validiert und normalisiert. Kanalspezifische Felder werden in ein internes Ordermodell übersetzt, Kunden- und Adressdaten geprüft und doppelte Events mithilfe von Idempotency Keys neutralisiert. So entsteht eine konsistente Grundlage, bevor Bestand reserviert oder ein Fulfillment-Auftrag angelegt wird.
Anschließend wendet das OMS die Entscheidungslogik an. Zahlungsstatus, Produktbeschränkungen, verfügbarer Bestand, Cut-off-Zeiten, Versandkosten, Land, Servicelevel und mögliche Margenauswirkungen werden gemeinsam bewertet. Erst wenn alle verpflichtenden Bedingungen validiert sind, erhält das ausgewählte WMS oder der 3PL-Dienstleister einen ausführbaren Pick-Pack-Ship-Auftrag. Jede Statusänderung wird danach erneut als Event an den Commerce-Kanal, die Kundenkommunikation, das ERP und die Analytics-Schicht veröffentlicht. Eine Änderung besitzt dadurch überall dieselbe Bedeutung und denselben Zeitstempel.
Retouren folgen derselben Architektur in umgekehrter Richtung. Ein RMA-Antrag wird zunächst anhand der Kanalbedingungen, des Retourenfensters, der Produktkategorie und des Kundenstatus geprüft. Gutschrift und Bestandskorrektur erfolgen nicht, weil ein Kalendertag erreicht ist, sondern auf Grundlage nachgewiesenen Eingangs, einer Inspektion und Klassifizierung. So entsteht eine geschlossene Kette, in der Outbound-Fulfillment und Retourenverarbeitung dieselben Identifikatoren, Events und Audit-Logs verwenden. Die Organisation sieht nicht nur, was geschehen ist, sondern kann auch rekonstruieren, welche Regel das Ergebnis bestimmt hat.
Das Datenmodell als Grundlage der Skalierbarkeit
Enterprise-Orchestrierung beginnt mit einem disziplinierten Datenmodell. Jede Order enthält sowohl die ursprüngliche Kanalidentifikation als auch eine interne oms_order_id, damit Quelle und zentrale Verarbeitung nachvollziehbar bleiben. Orderpositionen erfassen SKU, Variante, Menge, Preis, Steuer, Bundle-Beziehung und mögliche Einschränkungen ausdrücklich. Versandart, Carrier, Priorität und zugesagtes Lieferdatum dürfen keine Freitextfelder sein, sondern müssen Werte verwenden, die Regeln und Reports eindeutig interpretieren können. Diese Disziplin verhindert, dass Ausnahmen später in Code oder manuellen Arbeitsanweisungen verschwinden.
Idempotenz ist dabei eine operative Kontrolle und keine technische Verfeinerung. Webhooks werden erneut zugestellt, wenn ein Kanal nicht rechtzeitig eine Bestätigung erhält, und Netzwerkfehler können dieselbe Order mehrfach eintreffen lassen. Ohne eindeutigen Idempotency Key kann eine einzige Kundenaktion doppelte Reservierungen, doppelte Sendungen und fehlerhafte Umsatzbuchungen auslösen. Das OMS muss deshalb doppelte Events erkennen und sicher dasselbe Ergebnis zurückgeben, wenn eine frühere Verarbeitung bereits abgeschlossen ist. So werden Bestand, Marge und Reputation gleichzeitig geschützt.
Ein Event Store und eine relationale Reporting-Schicht erfüllen anschließend unterschiedliche Funktionen. Der Event Store bewahrt die chronologische Wahrheit jedes Übergangs, während relationale Tabellen den aktuellen Status, die finanzielle Wirkung und operative Aggregationen bereitstellen. Durch die Verbindung beider Perspektiven kann der operative Bereich in Echtzeit steuern und die Governance Entscheidungen nachträglich rekonstruieren. Aufbewahrungsregeln, Zugriffsrechte und Datenklassifizierung müssen bereits im Design festgelegt werden, weil Order- und Retourendaten personenbezogene Informationen, zahlungsbezogene Angaben und kommerziell sensible Muster enthalten.
Idempotenz ist keine technische Feinheit, sondern Risikokontrolle für Bestand, Kundenzusage und Umsatz.
Orchestrierungsregeln als strategisches Instrument
Der Wert eines OMS liegt nicht im Weiterleiten von Orders, sondern in der Qualität von Routing und Priorisierung. Bestandsverfügbarkeit ist nur ein Kriterium neben Land, Servicelevel, Logistikkosten, erwarteter Lieferzeit, Kapazität und Marge. Eine Order kann technisch von mehreren Standorten versendet werden, obwohl kommerziell nur eine Route optimal ist. Wird diese Abwägung zentral modelliert, entwickelt sich Fulfillment zu einer steuerbaren Entscheidung statt zu einer zufälligen Folge der Integration, die zuerst reagiert.
Cut-off-Regeln bestimmen, ob eine Order noch aus Distributionszentrum A versendet werden kann oder automatisch zu Distributionszentrum B wechseln muss. Bundle-Regeln können Orders desselben Kunden zusammenfassen, wenn Lieferzusage und Produkteigenschaften dies erlauben, während Split-Shipment-Regeln festlegen, wann Geschwindigkeit wichtiger ist als zusätzliche Versandkosten. Priorität kann anhand von SLA, Kundenwert, Backorder-Status oder Marktplatzverpflichtungen vergeben werden. Jede Regel benötigt dabei einen klaren Eigentümer, eine Version und eine wirtschaftliche Begründung.
Beherrschbarkeit ist entscheidend. Hardcodierte Regeln machen jede kommerzielle Änderung von einem Entwicklungszyklus abhängig und erhöhen das Risiko, dass alte Ausnahmen unbemerkt weiterbestehen. Eine Konfiguration über validierte Rule Sets oder eine einfache Verwaltungsoberfläche gibt Operations kontrollierte Flexibilität, sofern Freigaben, Tests und Rollback-Szenarien integriert sind. So kann die Organisation schnell auf saisonale Nachfrage, Carrier-Störungen oder Marktveränderungen reagieren, ohne dass lokale Optimierung die Logik der zentralen Kette durchbricht.
Retourenorchestrierung als Margensteuerung
Retouren werden häufig als administrativer Abschluss behandelt, obwohl sie Marge, Bestandsverfügbarkeit und Kundenwert direkt beeinflussen. Eine Retoure wird erst finanziell steuerbar, wenn das System zwischen wiederverkaufsfähigem Bestand, B-Ware, Reparatur, Lieferantenanspruch und vollständiger Abschreibung unterscheidet. Ohne zentrale Klassifizierung vermischen sich diese Ergebnisse und es bleibt unsichtbar, wo Wert zurückgewonnen oder verloren wird. Das OMS verbindet die physische Inspektion deshalb mit Bestandsaktion, Gutschrift und Reporting.
Dieselbe zentrale Logik muss Retourenfenster, Labelerstellung, Tracking und Ausnahmen kanalübergreifend steuern. Das bedeutet nicht, dass jeder Kanal identische Bedingungen erhält, wohl aber, dass alle Unterschiede als explizite Regeln dokumentiert werden. Ein Marktplatz kann ein längeres Retourenfenster als der eigene Shop anbieten, während bestimmte Produktkategorien eine zusätzliche Inspektion verlangen. Wird diese Variation in einem Modell verwaltet, bleibt die Ausführung konsistent und Finance kann die tatsächliche Retourenwirkung nach Kanal, SKU und Grund analysieren.
Finanzielle und operative Folgen je RMA-Ergebnis
Die folgende Klassifizierung zeigt, warum ein einziger generischer Retourenstatus nicht ausreicht. Jedes RMA-Ergebnis verlangt eine andere Bestandsaktion, finanzielle Behandlung und Managementfrage. Die Tabelle ist deshalb keine administrative Übersicht, sondern die Grundlage für Entscheidungen über Margenrückgewinnung, Secondary Sales, Produktqualität und Lieferantenmanagement. Werden Inspektionsergebnisse direkt in diesen Kategorien erfasst, kann das OMS ohne zusätzliche Interpretation die richtige Folgeaktion auslösen.
| RMA-Ergebnis | Bestandsaktion | Finanzielle Wirkung | Strategische Bedeutung |
|---|---|---|---|
| Wiederverkaufsfähig | Nach Qualitätsprüfung in den verfügbaren Bestand zurückführen | Weitgehende Margenrückgewinnung | Effiziente Retourenverarbeitung und schneller Wiederverkauf |
| B-Ware | Separater Bestandsstatus und angepasster Verkaufskanal | Teilweiser Wertverlust | Secondary Sales und kontrollierter Restwert |
| Reparatur oder Lieferantenanspruch | Sperren und einem Reparatur- oder Reklamationsprozess zuweisen | Kosten abhängig von der Erstattungsfähigkeit | Einblick in Produkt- und Lieferantenqualität |
| Abschreibung | Dauerhaft aus dem Bestand entfernen und Ursache erfassen | Vollständiger Verlust | Strukturelles Problem und unmittelbare Verbesserungspriorität |
Diese Struktur macht Retourendaten kommerziell nutzbar. Werden Ergebnisse mit SKU, Produktvariante, Kampagne, Verkaufskanal und Lieferant verknüpft, werden strukturelle Abweichungen sichtbar, bevor sie in Gesamtzahlen verschwinden. Marketing kann Erwartungen in Produktinhalten korrigieren, der Einkauf kann Qualitätsfragen mit Lieferanten klären und Finance kann echte Margenrückgewinnung von einer aufgeschobenen Abschreibung unterscheiden. Retourenorchestrierung wird so von einer Kostenerfassung zu einem Feedbackmechanismus für die gesamte kommerzielle Kette.
Statussynchronisierung als Reputationsschutz
Ein häufiges Problem in Multichannel-Umgebungen ist der Phantomstatus: Ein Marktplatz zeigt eine Order als versendet, obwohl das Lager noch nicht mit dem Picking begonnen hat, oder der Kunde erhält keine Verzögerungsmeldung, weil der Status das WMS nicht verlässt. Solche Unterschiede wirken technisch, berühren aber unmittelbar das Markenversprechen. Der Kunde beurteilt nicht, welches System verantwortlich war, sondern ob die Information korrekt und rechtzeitig ist und mit der tatsächlichen Lieferung übereinstimmt.
Das OMS muss deshalb ein kanonisches Statusmodell steuern, das kanalspezifische Begriffe in eine interne Bedeutung übersetzt. Ein WMS-Status wie allocated rechtfertigt möglicherweise noch keine Kundenmitteilung, während die Übernahme durch den Carrier eine belastbare Versandbestätigung liefert. Jeder Übergang enthält Quelle, Zeitstempel, Orderidentifikation und Grund, sodass Kanäle und Benachrichtigungen dieselbe Wahrheit verwenden. Dieser Ansatz reduziert Kundenanfragen und verhindert zugleich Marktplatz-Penalties sowie fehlerhaftes SLA-Reporting.
KPIs für Enterprise-Entscheidungen
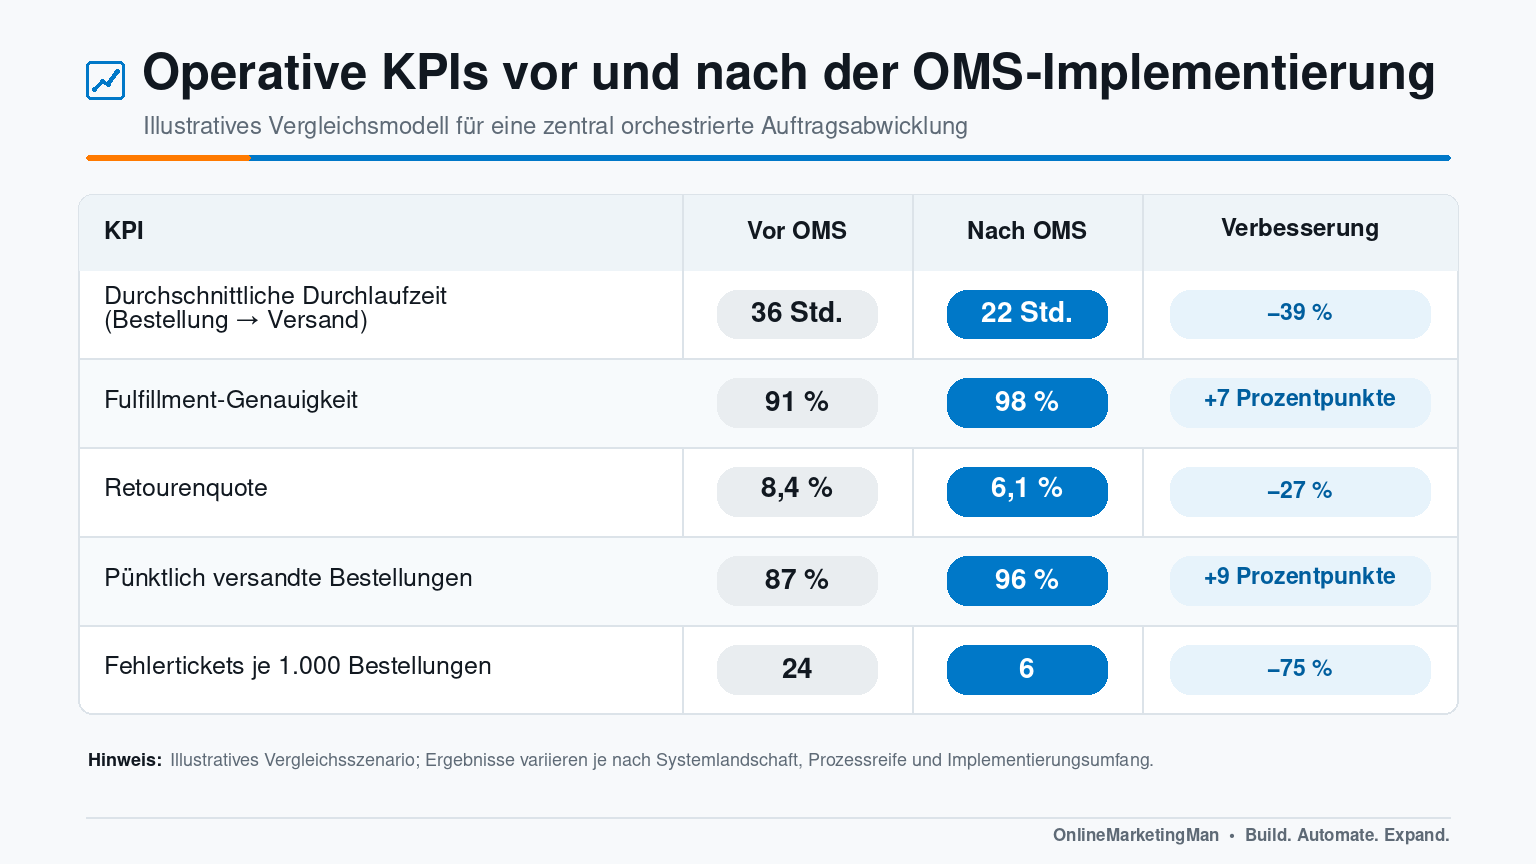
Die Gesamtzahl versendeter Orders und die durchschnittliche Durchlaufzeit geben zu wenig Aufschluss über die Robustheit. Durchschnittswerte verbergen Ausreißer, die gerade unter Spitzenlast Schäden bei Kunden und Marge verursachen. Die p95-Orderdurchlaufzeit zeigt deshalb, innerhalb welcher Zeit 95 Prozent der Orders verarbeitet werden, und macht die Leistung außerhalb der idealen Mitte sichtbar. Zusammen mit Fulfillment Accuracy und On-time Shipping entsteht ein verlässlicheres Bild der Prozessqualität als durch Volumen allein.
Steuerungsinformationen für Robustheit und kommerzielle Wirkung
Das folgende KPI-Set verbindet operative Leistung mit Managementfragen. Jede Kennzahl benötigt eine fest definierte Berechnungsmethode, Datenquelle, einen Eigentümer und eine Interventionsschwelle. Nur dann führt eine Abweichung zu einer Maßnahme statt zu einer Diskussion über die Zahlen. Bedeutung erhalten die Werte außerdem erst in ihrem Zusammenhang: Ein schnellerer Flow ist keine Verbesserung, wenn gleichzeitig Genauigkeit, Retourenquote oder Marge nachlassen.
| KPI | Bedeutung für die Steuerung | Beispiel für eine gezielte Intervention |
|---|---|---|
| p95-Orderdurchlaufzeit | Misst Robustheit jenseits des Durchschnitts | Kapazität oder Routing bei strukturellen Verzögerungen anpassen |
| Fulfillment Accuracy | Zeigt die Qualität von Picking, Packing und Orderdaten | Fehlermuster nach Standort, SKU oder Prozessschritt isolieren |
| Retourenquote nach Kanal und SKU | Erkennt Erwartungs-, Produkt- oder Qualitätsabweichungen | Inhalte, Sortiment oder Lieferantenvereinbarungen gezielt anpassen |
| On-time Shipping | Schützt Kundenzusage und Marktplatz-Ranking | Cut-off- oder Carrier-Regeln anhand realer Leistung neu kalibrieren |
| Kosten je Sendung | Macht die direkte Margenwirkung des Routings sichtbar | Bündelung, Standortwahl oder Service-Mix optimieren |
Die Beziehungen zwischen diesen Kennzahlen machen zentrale Orchestrierung finanziell sichtbar. Verbesserungen bei Durchlaufzeit, Fulfillment Accuracy und Retourenquote können einander verstärken, aber auch scheinbar positive Ergebnisse korrigieren. Niedrigere Kosten, die mehr Verzögerungen und Retouren erzeugen, sind kein Effizienzgewinn. Basieren alle KPIs auf denselben Order- und Eventidentifikatoren, kann das Management Ursache und Wirkung verfolgen und Investitionen auf Verbesserungen ausrichten, die die gesamte Kette stärken.
Architektur: schlank und Enterprise-tauglich
Eine wirksame OMS-Architektur muss weder schwergewichtig noch monolithisch sein. Webhooks bilden den primären Ingest, ergänzt durch kontrolliertes Fallback-Polling für Parteien, die keine zuverlässigen Push-Events bereitstellen können. Ein Message Broker wie SQS oder RabbitMQ entkoppelt Empfang und Verarbeitung, sodass eine vorübergehende Störung in einem WMS, Marktplatz oder Benachrichtigungsdienst nicht unmittelbar die gesamte Kette blockiert. Die Architektur wird dadurch resilient, ohne dass jedes System alle anderen Komponenten kennen muss.
Kleine Services für Normalisierung, Routing, RMA-Verarbeitung, Statusveröffentlichung und Benachrichtigungen grenzen Verantwortlichkeiten klar voneinander ab. Das bedeutet nicht, dass jede Funktion zu einem eigenen Microservice werden muss; die Grenze folgt der Änderungsgeschwindigkeit und dem operativen Risiko. Routingregeln ändern sich beispielsweise häufiger als finanzielle Buchungslogik und benötigen deshalb eine separat gesteuerte Domäne. API-Verträge, Versionskontrolle und Schemavalidierung verhindern, dass Modularität zu einem Netzwerk undurchsichtiger Abhängigkeiten wird.
Observability ist vom ersten Implementierungstag an Bestandteil der Architektur. Structured Logging, Trace-IDs, Metriken, Alerts und eine Dead-Letter Queue zeigen, wo ein Event stecken bleibt und welche Orders betroffen sind. Eine DLQ ist dabei kein Ablageort für vergessene Exceptions, sondern ein gesteuerter Recovery-Flow mit Eigentümer, Priorität und Wiederverarbeitungsverfahren. So kann Operations schnell iterieren, ohne Zuverlässigkeit zu opfern oder operative Schulden außerhalb der Managementsicht aufzubauen.
Implementierung in zehn Arbeitstagen: vom Nachweis zur Kontrolle
Eine Implementierung in zehn Arbeitstagen ist realistisch, wenn der Umfang bewusst auf einen nachweisbaren End-to-End-Flow begrenzt wird. Ziel ist nicht, in zwei Wochen sämtliche Kanäle, Retourentypen und Ausnahmen zu automatisieren, sondern die Kernarchitektur operativ zu beweisen. Ein Shop, ein Marktplatz und ein WMS oder 3PL-Dienstleister reichen aus, um Normalisierung, Idempotenz, Routing, Statusveröffentlichung und Observability unter realistischen Bedingungen zu testen. Der gewählte Use Case muss dennoch repräsentativ genug sein, um relevante Risiken sichtbar zu machen.
Die Umsetzung wird in vier kontrollierbare Arbeitsblöcke gegliedert. Jeder Block liefert ein greifbares technisches Ergebnis, eine operative Validierung und einen ausdrücklichen Entscheidungspunkt, bevor der nächste Abschnitt beginnt. Dadurch bleiben Abhängigkeiten sichtbar und das Team kann Abweichungen in der Phase beheben, in der sie entstehen, statt sie erst beim endgültigen Go-live zu entdecken:
- Die Arbeitstage eins und zwei definieren das kanonische Datenmodell, Identifikatoren, Idempotenz und API-Verträge einschließlich Testevents für reguläre Orders, Duplikate und unvollständige Kanaldaten.
- Die Arbeitstage drei bis fünf verbinden Ingest, Broker und Routing mit einem Fulfillment-Dienstleister und validieren anschließend Cut-off-Regeln, Fehlerbehandlung und Statusübergänge in einer kontrollierten Testumgebung.
- Die Arbeitstage sechs bis acht richten Rückveröffentlichung, Kundenbenachrichtigungen, Dashboards und einen repräsentativen RMA-Typ ein, damit Outbound- und Retourenevents innerhalb derselben nachvollziehbaren Kette funktionieren.
- Die Arbeitstage neun und zehn testen Grenzfälle und Spitzenlast im Shadow Mode, bewerten die operativen Ergebnisse und aktivieren erst danach kontrollierte Schreibrechte je Prozessschritt.
Der Shadow Mode verhindert, dass technische Validierung sofort operative Folgen erzeugt. Alle Events werden verarbeitet, Entscheidungen protokolliert und erwartete Ergebnisse mit dem bestehenden Betrieb verglichen, doch das OMS schreibt noch nicht aktiv zurück. Unterschiede werden als Modell-, Daten- oder Prozessfehler klassifiziert und zunächst behoben. Der Übergang zur aktiven Verarbeitung erfolgt anschließend pro Flow mit Rollback-Szenario, klaren Verantwortlichen und vorab festgelegten Akzeptanzkriterien. So maximiert das phasenweise Vorgehen den Lerneffekt, ohne den Livebetrieb als Testumgebung zu verwenden.
Häufige Fehler bei OMS-Implementierungen
Der erste Fehler besteht darin, die gesamte Orchestrierungslogik im ERP zu zentralisieren. Dadurch wird ein finanzielles Kernsystem von Regeln abhängig, die sich schnell ändern müssen, und es entstehen lange Releasezyklen für operative Anpassungen. Der zweite Fehler ist, Idempotenz erst nach der ersten Doppelverarbeitung hinzuzufügen. Zu diesem Zeitpunkt sind Orderidentität, Kompensationsregeln und Wiederherstellungsverfahren häufig bereits über mehrere Systeme verteilt. Beide Entscheidungen erhöhen die technische Schuld genau an den Stellen, an denen Zuverlässigkeit am wichtigsten ist.
Ein dritter Fehler ist das Fehlen einer ausgereiften Fehlerbehandlung. Ohne Dead-Letter Queue, Nachvollziehbarkeit und einen klaren operativen Eigentümer verschwinden Exceptions in Logs oder werden manuell außerhalb des Systems korrigiert. Das kann eine einzelne Order reparieren, zerstört aber den Audit-Trail und verhindert strukturelles Lernen. Ebenso problematisch sind hardcodierte Geschäftsregeln ohne Version, Begründung oder Rollback-Option. Die Organisation kann dann nicht rekonstruieren, welche Regel eine Entscheidung getroffen hat, und wird bei jeder Änderung von spezialisierter IT-Kapazität abhängig.
Schließlich wird die Kundenkommunikation oft erst am Ende ergänzt, als wäre sie vom Fulfillment getrennt. Der operative Bereich veröffentlicht zwar interne Statuswerte, aber der Kunde erhält Informationen zu spät, zu selten oder widersprüchlich. Proaktive ETA-Kommunikation, konsistente Kanalstatuswerte und Kontext für den Kundenservice müssen von Beginn an Teil derselben Eventarchitektur sein. Ein technisch korrekter Orderflow ist erst dann operativ ausgereift, wenn auch das Kundenversprechen nachweisbar gesteuert wird.
Zentrale Steuerung als Voraussetzung für Skalierung
Multichannel-Fulfillment wird nicht wegen der Zahl der Kanäle unbeherrschbar, sondern wegen fehlender gemeinsamer Logik. Solange Systeme nebeneinander arbeiten, entstehen Unterschiede bei Daten, Routing, Status und Retourenverarbeitung, die erst unter Belastung sichtbar werden. Eine OMS-Schicht verändert dieses Umfeld nicht durch den Ersatz von Kernsystemen, sondern indem sie die Entscheidungen zwischen ihnen zentral normalisiert und nachvollziehbar macht. Der operative Bereich wechselt dadurch vom Lösen einzelner Vorfälle zur gezielten Steuerung von Ausnahmen.
Diese Steuerung erfordert gemeinsame Verantwortung. Operations definiert Ausführung und Recovery-Prozesse, IT schützt Architektur und Zuverlässigkeit, Finance bestimmt die finanzielle Wahrheit und Margenwirkung, der Kundenservice sichert das Kundenversprechen und Commerce-Verantwortliche dokumentieren die Kanalbedingungen. Governance verhindert, dass jede Domäne lokal optimiert, während sich die Leistung der Gesamtkette verschlechtert. Entscheidungsrechte, Change-Prozess und KPI-Definitionen müssen deshalb ebenso explizit sein wie API-Verträge und Datenmodelle.
Multichannel-Komplexität entsteht nicht durch Volumen, sondern durch fehlende Steuerung von Daten, Entscheidungen und Ausnahmen.
Von operativer Komplexität zu steuerbarem Wachstum
Ein Enterprise-taugliches OMS-Programm wird nicht nach der Zahl verbundener Systeme beurteilt, sondern nach der Qualität der Entscheidungen, die die Kette auch unter Druck weiterhin trifft. Orders müssen eine einzige Identität behalten, Routing muss erklärbar sein, Retourenergebnisse müssen finanziell verarbeitet werden und jeder Status muss für Kunde und Betrieb dieselbe Bedeutung besitzen. Sind diese Bedingungen erfüllt, kann das Volumen steigen, ohne dass Nacharbeit, Fehlerrisiko und Abhängigkeit von individuellem Wissen proportional mitwachsen.
Die Implementierung sollte deshalb klein beginnen, doch das Design darf nicht provisorisch sein. Der erste Kanal und der erste Fulfillment-Dienstleister beweisen Datenmodell, Eventarchitektur, Observability und Governance, die später für weitere Märkte und Marken wiederverwendet werden. Jede nachfolgende Anbindung folgt denselben Verträgen und Kontrollpunkten, während lediglich kanalspezifische Regeln ergänzt werden. So wächst das System durch die Wiederholung eines bewährten Musters statt durch die Anhäufung von Ausnahmen.
Auch nach dem Go-live bleibt das OMS ein gesteuertes Produkt. KPIs, Retourengründe, Dead-Letter Events und manuelle Overrides zeigen, wo Regeln, Daten oder Prozesse nicht ausreichen. Ein fest verankerter Verbesserungsprozess übersetzt diese Signale in Hypothesen, kontrollierte Änderungen und messbare Ergebnisse. Operatives Wissen wird damit nicht länger nur in Personen oder Incident-Tickets gespeichert, sondern in die Architektur zurückgeführt, die künftige Entscheidungen unterstützt.
Der letztliche Gewinn ist größer als eine schnellere Orderverarbeitung. Zentrale Order- und Retourenorchestrierung schützt die Marge, macht Kundenzusagen verlässlicher und gibt dem Management Einblick in die wirtschaftlichen Folgen operativer Entscheidungen. Skalierung bedeutet dann nicht mehr, immer mehr Volumen durch dieselbe fragmentierte Kette zu zwingen, sondern eine Struktur zu schaffen, die neue Kanäle, Märkte und Fulfillment-Partner unter dieselbe Kontrolle aufnehmen kann. Darin liegt der Unterschied zwischen verbundenen Systemen und einem wirklich steuerbaren Multichannel-Betrieb.
FAQ – Häufig gestellte Fragen
1. Brauche ich ein teures OMS-Paket?
Nein. Beginnen Sie mit einer einfachen Serviceschicht + Warteschlange; der Wachstumspfad zum Unternehmen kann später erfolgen.
2. Was ist, wenn mein 3PL keine API hat?
Verwenden Sie SFTP-Aufträge mit Statusabfrage und Mapping; führen Sie Ereignisse weiterhin über OMS aus.
3. Wie kann ich doppelte Bestellungen vermeiden?
Idempotenzschlüssel + Ereignisspeicher + Wiederholungsversuche mit Back-Off.
4. Wann ist die Gutschrift nach der Rückkehr fällig?
Ereignisgesteuert nach Inspektion; nicht nach Kalenderdatum.
5. Was bringt die Bündelung?
Geringere Anzahl von Sendungen, bessere Termintreue, niedrigere Kosten pro Auftrag.
Verwandte Artikel zu Strategie, Automatisierung und Wachstum:
Echtzeit-Bestandssynchronisierung verhindert Overselling und Fehlbestände über alle Kanäle

Eine zentrale OMS-Architektur funktioniert nur, wenn Bestände auf Variantenebene in Echtzeit über alle Vertriebskanäle synchronisiert werden. Nur so lassen sich Fehlbestände, Overselling und Retourenprobleme systematisch vermeiden.
Zentrale Feed-Verteilung hält Produktdaten auf jedem Kanal konsistent

Eine strukturierte Produktdatenbasis ermöglicht konsistente Feed-Distribution und präzises Channel-Mapping. Dadurch wird jeder Vertriebskanal korrekt mit Daten versorgt – ohne operative Reibungsverluste.
Zentrale Order-Orchestrierung macht Multi-Shop-Wachstum planbar und kontrollierbarS

Order- und Retourenorchestrierung bildet das operative Rückgrat eines skalierbaren Shopportfolios. Mehrere Stores lassen sich zentral steuern, ohne dass Prozesse fragmentieren oder operative Komplexität entsteht.
OnlineMarketingMan
Build. Automate. Expand.