
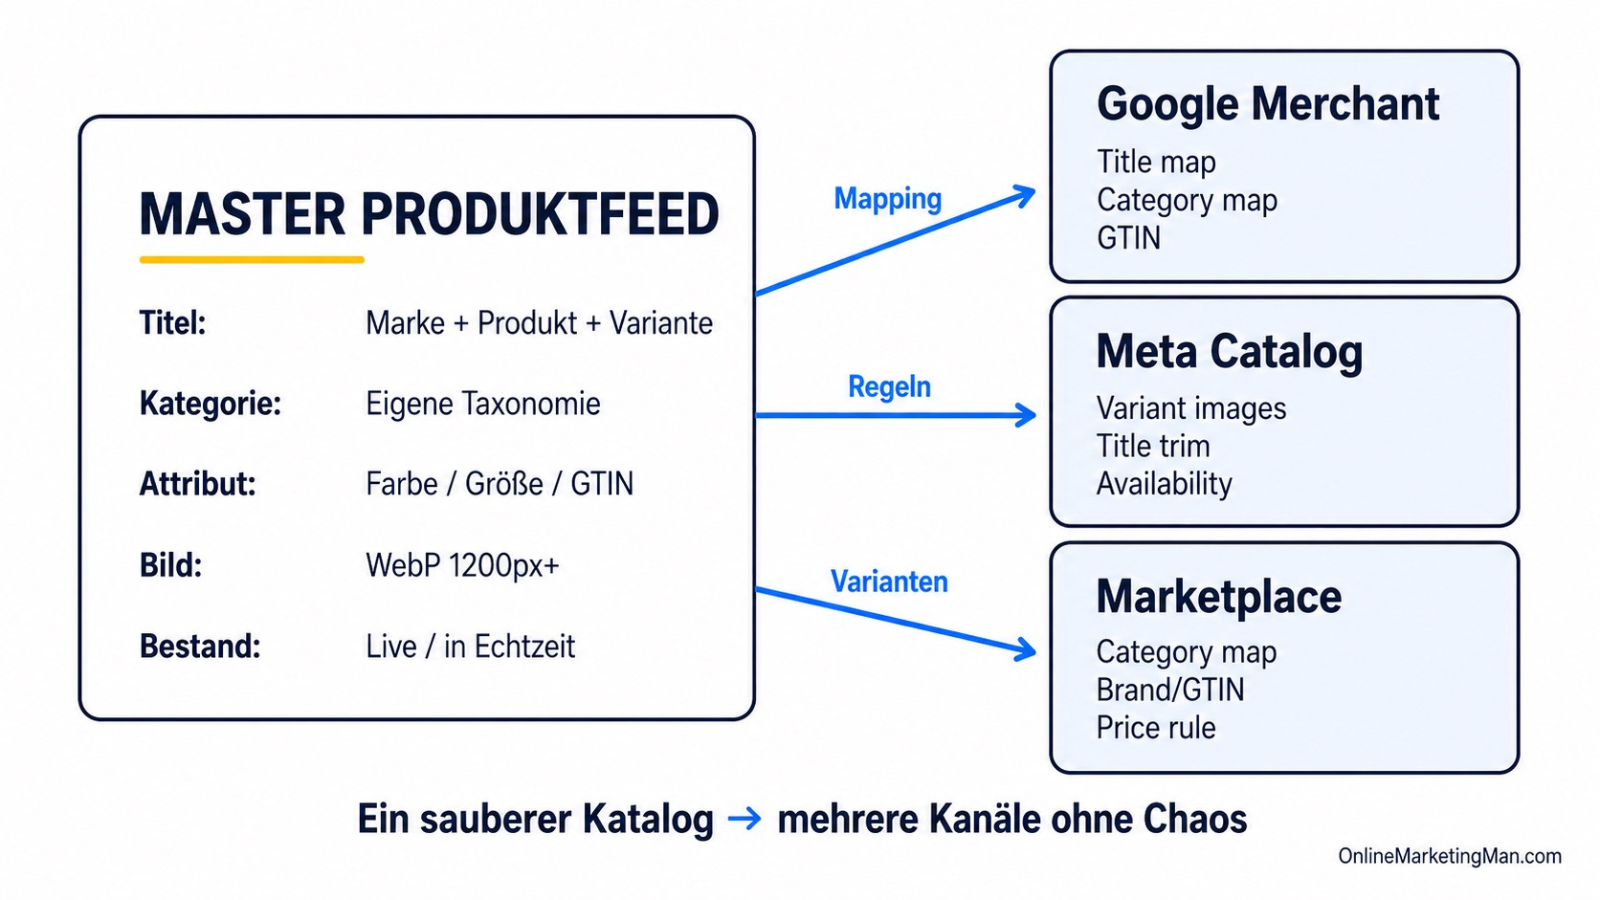
Feed-Distribution und Channel Mapping: ein Katalog, mehrere Kanäle
E-Commerce-Wachstum wird immer weniger von der Leistung eines einzelnen Vertriebskanals bestimmt und zunehmend von der Frage, ob Produktdaten kontrolliert in unterschiedlichen kommerziellen Ökosystemen eingesetzt werden können. Ein Produkt erscheint nacheinander in Suchergebnissen, Anzeigen, Filtern, Marketplaces und Social-Media-Katalogen, während jede Plattform dieselben Quelldaten nach eigenen Regeln interpretiert. Wenn Titel, Kategorien, Varianten, Preise und Verfügbarkeit je Kanal separat verwaltet werden, entstehen mehrere Versionen derselben kommerziellen Realität. Das Ergebnis ist nicht nur zusätzlicher Pflegeaufwand, sondern auch ein Verlust an Verlässlichkeit bei Sichtbarkeit, Conversion und Reporting.
Feed-Distribution ist daher eine Frage der kommerziellen Steuerung. Die Organisation muss erklären können, welche Produktinformationen jeder Kanal erhält, warum diese Informationen von der Quelle abweichen und welchen Einfluss eine Änderung auf Auffindbarkeit und Verkaufsfähigkeit hat. Ohne diese Nachvollziehbarkeit wächst die Zahl der Veröffentlichungen, während die Kontrolle über das Sortiment abnimmt. Die Kernfrage lautet daher nicht, wie viele Kanäle angebunden werden können, sondern ob dieselbe Produktentscheidung überall vorhersehbar umgesetzt wird.
Vom Kanalmanagement zur Distributionslogik
In einer kanalorientierten Struktur wird der Onlineshop meist als primäre Veröffentlichungsumgebung genutzt und jeder zusätzliche Kanal erhält eigene Anpassungen. Marketplace-Kategorien werden manuell ausgewählt, Anzeigentitel lokal umgeschrieben und abweichende Preise oder Produktmerkmale in separaten Dateien gepflegt. Solange das Sortiment klein ist und sich wenig verändert, wirkt diese Arbeitsweise beherrschbar. Mit mehr Varianten, Ländern und Promotions wächst die Zahl der Abhängigkeiten jedoch schneller als das Verkaufsvolumen, weil dieselbe Änderung an mehreren Stellen erneut interpretiert und kontrolliert werden muss.
Ein Distributionsmodell verlagert diese Logik aus den einzelnen Kanälen in eine zentrale Ebene. Der Masterkatalog enthält stabile Identifikatoren, Produktbeziehungen und validierte Quellwerte, während Distributionsregeln bestimmen, welche Felder ausgewählt, angepasst oder ausgeschlossen werden. Ein Kanal erhält dadurch keine beliebige Kopie der Quelle, sondern eine reproduzierbare Veröffentlichung, die auf ein festgelegtes Regelwerk zurückgeführt werden kann. Korrekturen werden einmal vorgenommen und anschließend kontrolliert verteilt. Das begrenzt lokale Workarounds und macht sichtbar, welche Abweichungen aus Quelldaten, Mapping oder Plattformvalidierung entstehen.
Distribution wird unbeherrschbar, sobald dieselbe Produktwahrheit an mehreren Stellen unabhängig voneinander verändert wird.
Channel Mapping als steuerbare Übersetzungsebene
Channel Mapping verbindet die interne Produktstruktur mit Taxonomie, Felddefinitionen und kommerzieller Logik jeder externen Plattform. Amazon und Bol.com legen vergleichsweise großen Wert auf Kategoriezuordnung, Templatefelder und Vollständigkeit innerhalb ihrer eigenen Produkttypen. Google Merchant Center nutzt strukturierte Attribute, um Angebote mit Suchintention und Anzeigenkontext zu verknüpfen, während Meta stärker von Katalogbeziehungen, visuellen Merkmalen und Engagement-Signalen abhängt. Ein Feed kann daher technisch akzeptiert werden und dennoch kommerziell unterperformen, wenn die Bedeutung der Daten nicht zum Kontext des Kanals passt.
Die Mapping-Ebene übersetzt diese Unterschiede, ohne den zentralen Katalog zu fragmentieren. Interne Kategorien werden mit Kanaltaxonomien verknüpft, Merkmale verpflichtenden oder empfohlenen Feldern zugeordnet und Titelregeln an verfügbaren Raum und Suchverhalten angepasst. Auch Parent-Child-Beziehungen, Maßeinheiten und kanalspezifische Ausschlüsse werden hier verwaltet. Jede Transformation erhält einen Eigentümer und eine Version, sodass Änderungen getestet und zurückgerollt werden können. Damit ist Channel Mapping keine Sammlung manueller Feldverknüpfungen, sondern ein steuerbares Interpretationsmodell für Produktdaten.
Vier Kontrollen bestimmen, ob diese Übersetzungsebene kommerziell nutzbar bleibt:
- Kategorien passen nachweislich zur Taxonomie und Filterstruktur der Plattform;
- verpflichtende und kommerzielle Attribute sind vollständig, korrekt typisiert und aktuell;
- Titel und Beschreibungen folgen den Kanalregeln, ohne die Produktbedeutung zu verändern;
- Bilder, Merkmale und Verfügbarkeit verweisen auf dieselbe verkaufsfähige Ausführung.
Diese Kontrollen verhindern, dass ein korrektes Produkt in einem ungeeigneten Suchkontext landet oder wegen fehlender Merkmale außerhalb relevanter Filter bleibt. Sie unterscheiden außerdem zwischen technischer Abdeckung und kommerzieller Abdeckung. Ein Artikel, der live ist, aber nicht nach Größe, Material oder Anwendung auffindbar ist, gilt technisch als veröffentlicht, obwohl ein wesentlicher Teil der Nachfrage ihn nicht erreichen kann. Die Qualität des Channel Mappings muss daher anhand nutzbarer Auffindbarkeit beurteilt werden und nicht ausschließlich anhand der Zahl akzeptierter Produkte.
Distributionsqualität bestimmt Performance und Analyse
Der erste Performance-Effekt entsteht bereits vor dem Klick. Korrekt zugewiesene Kategorien und vollständige Attribute erhöhen die Wahrscheinlichkeit, dass ein Produkt in relevanten Suchergebnissen, Filtern und Anzeigenauswahlen erscheint. Dadurch steigt nicht nur die Reichweite, sondern vor allem die Qualität des Traffics. Wenn Nutzer eine Ausführung sehen, die zu ihrer Suchanfrage passt, werden Klick- und Conversion-Raten weniger abhängig von breitem Targeting oder zusätzlichem Mediabudget. Feedqualität beeinflusst so die Effizienz der Akquisition, ohne dass die Kampagnenstruktur selbst verändert werden muss.
Distribution bestimmt auch, wie schnell neues Sortiment kommerziell einsetzbar wird. Eine validierte Produktstruktur reduziert Kanalablehnungen, verhindert Korrekturschleifen und macht deutlich, welche Daten vor der Veröffentlichung noch fehlen. Dadurch verkürzt sich die Zeit zwischen Produkteinführung und Verkauf, während unvollständige Artikel nicht vorzeitig in Kanälen erscheinen. Diese Vorhersehbarkeit ist besonders bei Saisonprodukten und Kampagnen mit festem Starttermin relevant. Eine verzögerte Veröffentlichung ist dort nicht nur ein technischer Vorfall, sondern der Verlust eines begrenzten Verkaufsfensters.
Darüber hinaus bildet konsistente Distribution die Grundlage für verlässliche Vergleiche zwischen Kanälen. Wenn dasselbe Produkt mit unterschiedlichen Kategorien, Titeln oder Variantenbeziehungen angeboten wird, lassen sich Unterschiede bei Reichweite und Conversion nicht sauber auf Nachfrage, Preis oder Kanalqualität zurückführen. Zentrales Mapping reduziert dieses Messrauschen, weil die Quellwerte gleich bleiben und Transformationen nachvollziehbar sind. Analysten können dadurch unterscheiden, ob ein Performance-Unterschied aus Marktverhalten oder aus der Art der Dateninterpretation entsteht. Optimierung verlagert sich damit von Symptombekämpfung zu Entscheidungen auf Basis kontrollierbarer Daten.
Architektur und Governance als Grundlage für Skalierung
Eine skalierbare Struktur trennt Produktwahrheit, Distributionslogik und Qualitätskontrolle. Der Masterfeed verwaltet stabile Quelldaten und Beziehungen, die Distributionsebene übersetzt diese Daten in Kanalprofile und die Validierung kontrolliert das Ergebnis vor der Veröffentlichung. Ohne diese Trennung landen Kanalausnahmen in Quellfeldern, werden Mappings in separate Exporte kopiert und es ist nicht länger klar, welche Logik führend ist. Eine Änderung wird dann erst beherrschbar, nachdem alle Veröffentlichungen manuell verglichen wurden. In einer geschichteten Architektur bleibt jedes Ergebnis auf einen Quellwert und eine angewandte Regel zurückführbar.
| Komponente | Verantwortung | Kontrollpunkt |
|---|---|---|
| Masterfeed | Produktwahrheit, Identifikatoren und Beziehungen | Vollständigkeit, Aktualität und Konsistenz |
| Distributionsebene | Kanalregeln und Transformationen | Versionsverwaltung, Eigentümerschaft und Rollback |
| Validierung | Technische und kommerzielle Qualitätskontrolle | Ablehnungen, Abweichungen und Verarbeitungszeit |
| Monitoring | Überwachung nach der Veröffentlichung | Abdeckung, Preis, Bestand und Variantenstatus |
Governance legt fest, wer Quellfelder, Mapping-Regeln und Ausnahmen ändern darf und welche Prüfung erforderlich ist, bevor eine neue Version live geht. Jede wesentliche Änderung erhält ein Ziel, einen Eigentümer, ein Testergebnis und ein Rückfallszenario. Das Monitoring kontrolliert anschließend, ob die Veröffentlichung im Kanal dem erwarteten Ergebnis entspricht; ein erfolgreicher Export sagt schließlich noch nichts über korrekte Kategorisierung oder Verkaufsfähigkeit aus. Durch die Rückführung von Abweichungen an die verantwortliche Ebene entsteht ein geschlossener Steuerungskreislauf. Teams beheben dann nicht nur das sichtbare Problem, sondern verbessern die Quelle oder Regel, die das Problem verursacht hat.
Implementierung als kontrollierter Prozess
Die Implementierung beginnt mit Scope und Akzeptanzkriterien, nicht mit der Aktivierung möglichst vieler Kanäle. Pro Produktgruppe wird festgelegt, welche Identifikatoren und Quellfelder führend sind, welche Attribute kommerziell notwendig sind und welche Ausnahmen ausdrücklich unterstützt werden müssen. Anschließend wird der Masterfeed bereinigt: Doppelte Werte werden entfernt, Einheiten standardisiert und Parent-Varianten-Beziehungen auf SKU-Ebene validiert. Ein ausgefülltes Feld gilt dabei nicht automatisch als korrekte Datenbasis; Werte müssen auch aktuell, semantisch richtig und untereinander konsistent sein. Diese Bestandsaufnahme verhindert, dass bestehende Fehler über eine effizientere Distributionsebene schneller verbreitet werden.
Die erste Veröffentlichung fungiert als formales Entscheidungstor und nutzt ein repräsentatives Testset mit einfachen Produkten, Varianten, temporären Bestandsstatus und abweichenden kommerziellen Bedingungen. Die Kontrolle erfolgt sowohl in der ausgehenden Nachricht als auch in der sichtbaren Kanalansicht, weil eine technisch korrekte Verarbeitung weiterhin zu einer unbrauchbaren Darstellung führen kann. Jede Feststellung erhält eine Ursache, einen Eigentümer und einen erneuten Test; lokale Reparaturen im Kanal gelten nicht als Abnahme. Das Sortiment wird erst erweitert, wenn die vereinbarten Fehlergrenzen, Verarbeitungszeiten und Wiederherstellungsverfahren nachweislich funktionieren.
Praxisbeispiel: vom Mediaproblem zur Datenkorrektur
Ein international tätiger Händler verzeichnete sinkende Marketplace-Performance, während die Werbeinvestitionen stiegen. Die ersten Analysen konzentrierten sich auf Gebotsstrategien, Targeting und Wettbewerbsdruck, doch Anpassungen brachten keine stabile Verbesserung. Beim Vergleich der veröffentlichten Kataloge zeigte sich, dass Kategorien je Kanal unterschiedlich angewendet wurden, kommerzielle Attribute fehlten und Varianten nicht konsequent als separate Ausführungen angeboten wurden. Die Produkte waren technisch sichtbar, passten jedoch nicht ausreichend zu Filtern und Suchkontexten. Die Algorithmen erhielten dadurch schwache Relevanzsignale, die auch mit zusätzlichem Werbebudget nicht strukturell korrigiert werden konnten.
Der Händler führte Identifikatoren und Variantenbeziehungen auf einen einzigen Masterfeed zurück und legte Kanaltaxonomien sowie Attributregeln in einer zentralen Mapping-Ebene fest. Produkte wurden mit konsistenten Parent-Child-Beziehungen, vollständigen Merkmalen und kanalspezifischer Kategorisierung erneut veröffentlicht. Anschließend wurde je Kategorie gemessen, wie viele Artikel in relevanten Filtern erschienen, wie häufig Veröffentlichungen abgelehnt wurden und welche Suchkontexte Traffic erzeugten. Die Conversion stabilisierte sich ohne zusätzliches Mediabudget, während neue Artikel schneller aktiviert werden konnten. Die Verbesserung entstand nicht durch breitere Distribution, sondern durch eine präzisere Interpretation desselben Sortiments.
Variantenebene verhindert strukturellen Relevanzverlust
Bei Sortimenten mit Größe, Farbe, Material oder Ausführung wird kommerzielle Relevanz auf Variantenebene bestimmt. Ein Nutzer sucht nicht nach einem abstrakten Parent-Produkt, sondern nach einer verfügbaren Konfiguration, die zu einem konkreten Bedarf passt. Wenn Varianten nicht separat mit Filtern, Anzeigen und Bestandsstatus verknüpft werden, kann ein Produkt sichtbar sein, während die gewünschte Ausführung nicht auffindbar ist. Umgekehrt kann das vollständige Produkt aus dem Blickfeld verschwinden, weil eine Variante fehlt. Beide Situationen verzerren das Verhältnis zwischen tatsächlicher Nachfrage und gemessener Interaktion.
Ein ausgereiftes Distributionsmodell gibt jeder Variante einen stabilen Identifikator, eigene Merkmale, aktuelle Verfügbarkeit und eine passende visuelle Darstellung. Die Parent-Struktur bündelt Ausführungen für Navigation und Reporting, nimmt ihnen jedoch nicht ihre kommerzielle Eigenständigkeit. Mapping-Regeln stellen sicher, dass Kanalfelder dieselbe Variantenbeziehung korrekt interpretieren und dass Bilder, Preis und Bestand bei der richtigen SKU bleiben. Dadurch können Plattformen präziser matchen und die Performance je Ausführung bleibt analysierbar. Einkauf, Advertising und Sortimentsmanagement steuern dann auf derselben Variantendefinition statt auf zusammengefassten Produktsummen.
Strukturelle Fehler werden sichtbar, wenn nicht nur Ablehnungen, sondern auch Datenabdeckung und Kanalverhalten gemessen werden. Relevante Indikatoren sind der Anteil verkaufsfähiger Varianten, die korrekt veröffentlicht wurden, fehlende kommerzielle Attribute, Unterschiede bei Preis oder Bestand und Produkte, die außerhalb erwarteter Filter liegen. Jede Abweichung erhält eine Wirkungsklasse auf Basis von Umsatzpotenzial und Kanalreichweite. Dadurch erhalten Topseller mit falschem Variantenstatus früher Aufmerksamkeit als langsam verkaufende Artikel mit einer kosmetischen Content-Abweichung. Monitoring wird so zu einem Priorisierungsmechanismus und nicht zu einer langen Liste technisch gleichwertiger Meldungen.
Internationale Distribution ohne Katalogfragmentierung
Internationale Expansion fügt demselben Distributionsmodell Sprache, Währung, Regulierung, Logistik und lokale Taxonomien hinzu. Wenn jeder Markt eine eigene Katalogkopie erhält, entstehen Abweichungen in Produktdefinitionen und Korrekturen werden von lokalen Pflegerunden abhängig. Eine zentrale Architektur hält Identifikatoren, Produktbeziehungen und nicht sprachgebundene Merkmale gleich, während marktgebundene Werte in separaten, kontrollierten Ebenen ergänzt werden. Übersetzungen, Preisregeln, Verfügbarkeit und gesetzliche Informationen erhalten damit einen expliziten Scope. Lokale Relevanz entsteht, ohne dass die zentrale Produktwahrheit je Land neu aufgebaut wird.
Ein neuer Markt wird zunächst mit einer begrenzten, repräsentativen Produktauswahl validiert. Taxonomie, Sprachfelder, Währung, Lieferversprechen und Rückgabebedingungen werden kontrolliert, bevor das vollständige Sortiment freigegeben wird. Abweichungen erhalten Grenzwerte, die bestimmen, wann eine Veröffentlichung verlangsamt oder vorübergehend gestoppt wird. Dadurch kann die Organisation aus lokalen Plattformanforderungen lernen, ohne dass Fehler unmittelbar über Tausende Produkte verteilt werden. Internationale Expansion wird so zu einer wiederholbaren Implementierung bestehender Prinzipien, ergänzt durch kontrollierte lokale Variation.
Ein neuer Kanal ist erst dann skalierbar, wenn er hinzugefügt werden kann, ohne eine neue Produktwahrheit zu schaffen.
Vom Feedmanagement zur kommerziellen Steuerung
Kommerzielle Steuerung beginnt mit Priorisierung. Nicht jede Datenmeldung verdient dieselbe Reihenfolge bei der Behebung: Eine falsche Kategorie bei einem Topseller hat eine andere Auswirkung als ein fehlendes sekundäres Merkmal bei einem Produkt mit geringem Volumen. Deshalb werden Abweichungen nach Umsatzpotenzial, Kanalreichweite, Kundenauswirkung und Zeitkritikalität gewichtet. Die Maßnahmenplanung folgt dieser geschäftlichen Auswirkung statt der Zahl der Meldungen oder der Reihenfolge ihres Eingangs. So wird Distributionsmanagement Teil der Portfoliosteuerung und nicht ausschließlich eine technische Warteschlange.
Die feste Steuerung umfasst mindestens vier Bestandteile:
- Eigentümerschaft für Quelldaten, Kanalmapping, Validierungsregeln und Ausnahmen;
- Servicelevels für Veröffentlichungsgeschwindigkeit, Datenabdeckung und Behebung von Abweichungen;
- Versionsverwaltung und Rollback für Änderungen, die mehrere Kanäle beeinflussen;
- periodische Bewertung von Datenqualität, Kanalperformance und kommerzieller Auswirkung.
Die Steuerung ist erst vollständig, wenn Entscheidungen nachweislich abgeschlossen werden. Jede strukturelle Abweichung erhält einen Eigentümer, ein Korrekturdatum und einen Verifikationszeitpunkt; temporäre Workarounds erhalten ein Ablaufdatum. Nach der Behebung wird kontrolliert, ob nicht nur die Veröffentlichung, sondern auch der betreffende kommerzielle Indikator wieder normalisiert ist. Dadurch bleiben Notlösungen nicht unbemerkt bestehen und es wird sichtbar, welche Verbesserungen tatsächlich Wirkung erzielen. Feedmanagement entwickelt sich so von der Incident-Bearbeitung zu einem kontrollierbaren Zyklus aus Erkennen, Entscheiden, Beheben und Verifizieren.
Kommerzielle Steuerung verlangt schließlich eine feste Beziehung zwischen Datenqualität und Ergebnis. Pro Kategorie wird verfolgt, welche Verbesserungen bei Attributabdeckung, Filterbarkeit und Veröffentlichungsgeschwindigkeit mit Reichweite, Conversion und Bruttomarge zusammenhängen. Dabei wird eine Änderung zunächst auf eine abgegrenzte Produktgruppe angewendet, sodass ihr Effekt mit einer unveränderten Kontrollgruppe verglichen werden kann. Nur Verbesserungen, die nachweislich und dauerhaft Wert schaffen, werden breiter ausgerollt. Dadurch verändert sich Feedoptimierung von einer Reihe von Annahmen zu einem steuerbaren Verbesserungsprogramm, in dem Datenteams, E-Commerce und Finance dieselben Entscheidungskriterien verwenden.
Gemeinsam intelligenter skalieren?
Möchten Sie mit einem Katalog mehrere Kanäle bedienen, ohne Chaos zu erzeugen?
Lesen Sie Warum es funktioniert für unseren pragmatischen Ansatz.
FAQ – Intelligente Marketing-Automatisierung OnlineMarketingMan
1) Was meinen Sie mit „Marketingkampagnen, die sich selbst steuern“?
Kampagnen reagieren automatisch auf das Verhalten von Kunden (Trigger und Segmentierung). Beispiele sind Willkommens- und Nurture-Flows, Reaktivierungskampagnen und dynamische Anzeigen, die ohne manuelle Eingriffe weiterlaufen.
2) Welche Tools verwenden Sie für Marketing Automation?
Vor allem Salesforce Marketing Cloud (u. a. Account Engagement), ergänzt – je nach Anwendungsfall – durch HubSpot oder ActiveCampaign, häufig integriert mit Shopify oder WooCommerce.
3) Ist Marketing Automation nur für große Unternehmen geeignet?
Nein. Beginnen Sie klein mit grundlegenden Automations-Flows (Willkommensserie, Warenkorbabbruch, Lead-Nurturing) und skalieren Sie, sobald Daten und Ergebnisse wachsen.
4) Wie viel Zeit spart intelligente Automatisierung?
Als Richtwert: 40–60 % weniger repetitive Marketingaufgaben (Follow-ups, Segmentierung, Reporting). Die gewonnene Zeit kann in kreative und strategische Arbeit investiert werden.
5) Wie entscheide ich, was ich zuerst automatisieren sollte?
Beginnen Sie mit wiederkehrenden und konversionskritischen Prozessen: Lead-Follow-up, Onboarding, Back-in-Stock-Benachrichtigungen und Post-Purchase-Flows. Starten Sie mit einem Flow und erweitern Sie ihn iterativ.
6) Was passiert, wenn eine Automation falsch ausgelöst wird?
Arbeiten Sie mit Testsegmenten, klarer If/Then-Logik und Sandbox-Tests. Protokollieren Sie alle Events und richten Sie Alerts für fehlgeschlagene Sends oder API-Fehler ein.
7) Wie kombiniert man Automatisierung mit Personalisierung?
Nutzen Sie Kundendaten als Grundlage: Verhalten, Kaufhistorie und Produktinteressen. Zeigen Sie dynamische Inhalte und Empfehlungen pro Segment oder Persona.
8) Ist Automatisierung nicht unpersönlich?
Im Gegenteil: Sie macht Kommunikation relevanter. Die richtige Botschaft erreicht die richtige Person zum richtigen Zeitpunkt, basierend auf Kontext. Wichtig sind klare Opt-out-Möglichkeiten und Präferenzoptionen.
9) Wie messe ich den ROI von Marketing Automation?
Überwachen Sie Conversion-Rate, Customer Lifetime Value, Retention und Umsatz pro Flow. Nutzen Sie Dashboards (z. B. in GA4 oder BI-Tools) und verknüpfen Sie Kosten, um ROAS und ROI pro Journey zu analysieren.
10) Womit sollte ich heute beginnen?
Starten Sie mit einer konkreten Nurture-Serie oder einem Warenkorbabbruch-Flow. Definieren Sie Trigger, Inhalte und Erfolgsmetriken, testen Sie und skalieren Sie anschließend kontrolliert.
Links zu externen Behörden
Verwandte Artikel zu Strategie, Automatisierung und Wachstum
DATENQUALITÄT, DIE VERKAUFT
DATEN NORMALISIEREN UND ANREICHERN

Channel-Mapping funktioniert nur, wenn Produktdaten zunächst normalisiert und angereichert werden. Erst dann erhalten Vertriebskanäle konsistente, vollständige und kommerziell verwertbare Informationen.
API-FEEDS MIGRIEREN
FAHRPLAN FÜR STABILE FEEDSTRUKTUREN

Eine effiziente Distributionsstruktur erfordert stabile Feedmigrationen, bei denen Produktstrukturen, Attribute und kanalspezifische Logik zuverlässig erhalten bleiben.
DYNAMISCHE PREISGESTALTUNG
MARGEN AUTOMATISCH MAXIMIEREN

Feeddistribution wird profitabel, wenn Preisregeln und Margenkalkulationen kanalübergreifend automatisch innerhalb einer zentralen Katalogstruktur angewendet werden.
OnlineMarketingMan
Build. Automate. Expand.