
Hinter den Kulissen des E-Commerce: warum Marketing scheitert, wenn die Supply Chain hakt
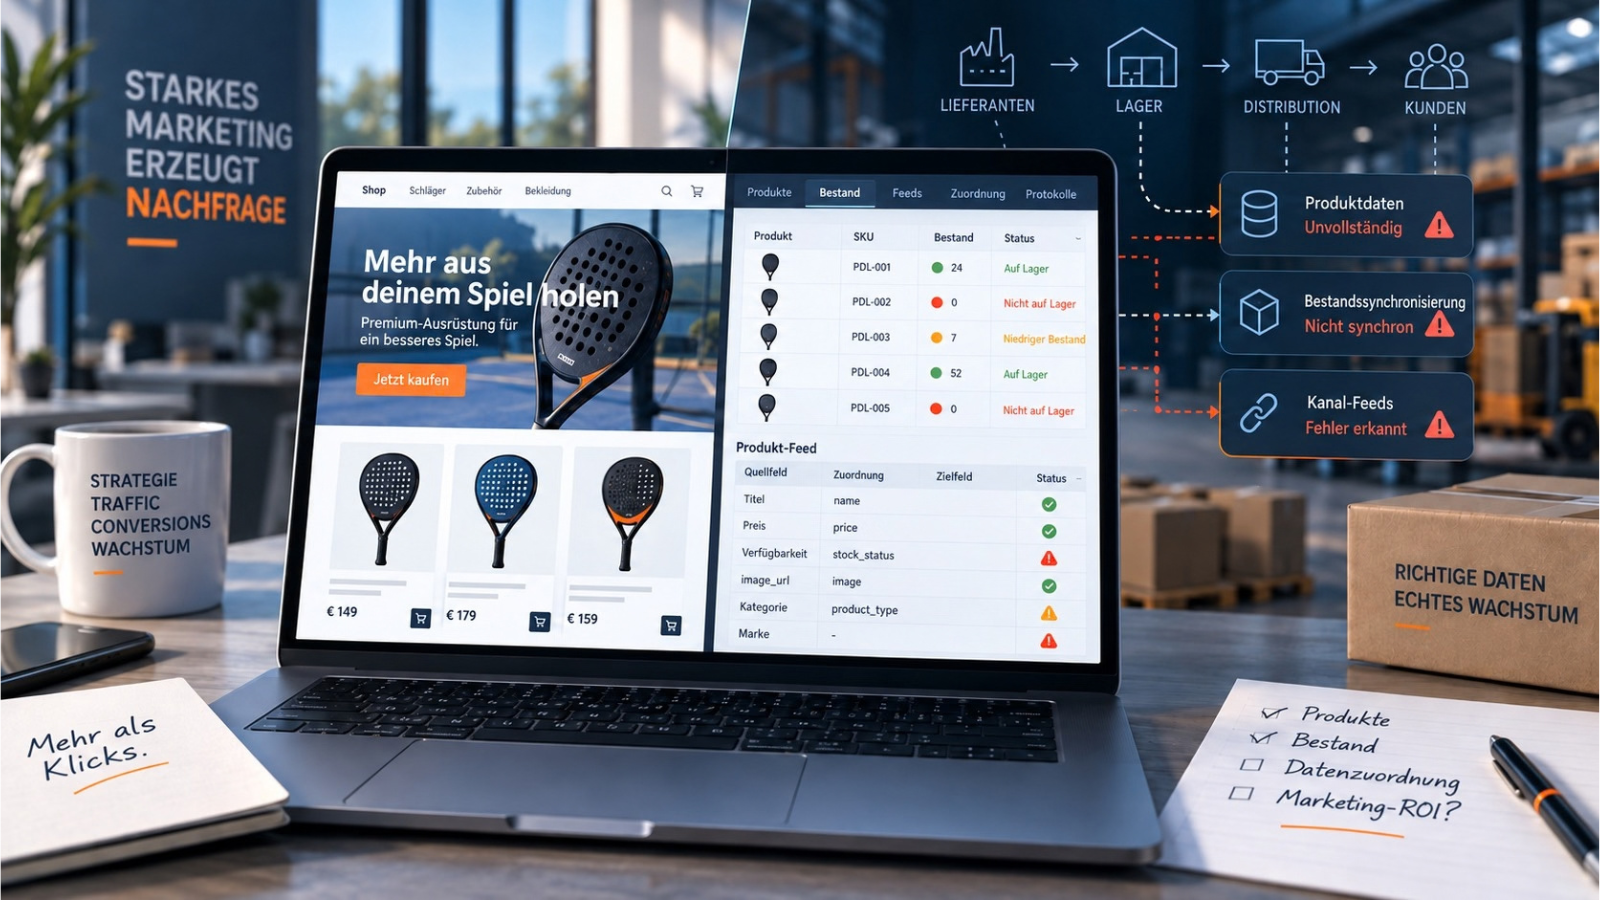
Im E-Commerce richtet sich erstaunlich viel Aufmerksamkeit auf das, was der Kunde sieht. Wir optimieren Anzeigen, Produktseiten, Customer Journeys, Checkout-Prozesse und Conversion Rates, während Dashboards immer genauer zeigen, wo Besucher abspringen und welche Kampagne Umsatz generiert. Diese Arbeit ist wichtig, bildet jedoch nur die Vorderseite des kommerziellen Systems ab. Hinter jedem Klick befindet sich eine wesentlich weniger sichtbare Kette aus Produktdaten, Beständen, Lieferanten, Einkaufskonditionen und Systemintegrationen. Wenn diese Rückseite nicht zuverlässig funktioniert, kann starkes Marketing das Problem sogar vergrößern, indem es zusätzliche Nachfrage nach Produkten erzeugt, die nicht oder wirtschaftlich nicht sinnvoll geliefert werden können.
Das wurde kürzlich erneut bei einer Bestands- und Datenoperation für einen spezialisierten niederländischen Onlineshop für hochwertige Sportausrüstung deutlich. Das Sortiment umfasst mehr als vierhundert Modelle und Varianten, die zu einem erheblichen Teil von einem internationalen Hauptlieferanten abhängig sind. Bei einem Sortiment dieser Größe ist ein aktueller Lagerbestand kein administratives Detail. Bestellt ein Kunde ein bestimmtes Modell, das laut Onlineshop verfügbar ist, über den geschäftlichen Einkaufskanal jedoch inzwischen nicht mehr geliefert werden kann, endet eine erfolgreiche Conversion dennoch mit einer Stornierung, Rückerstattung und einem enttäuschten Kunden. Die E-Commerce Supply Chain bestimmt damit unmittelbar, ob das kommerzielle Versprechen an der Vorderseite tatsächlich eingehalten werden kann.
Was zunächst wie eine routinemäßige Synchronisierung von Bestandsdaten aussah, machte sichtbar, wie viele verschiedene Systeme hinter einem scheinbar einfachen Lagerstatus stehen. Produktnamen waren nicht überall identisch, eindeutige Artikelnummern standen nicht in jeder Datenquelle zur Verfügung, EAN-Codes stimmten nicht immer überein und die öffentliche Verbraucherwebsite des Lieferanten zeigte mitunter eine andere kommerzielle Realität als das geschäftliche B2B-Portal. Das sind keine exotischen Ausnahmen, die nur bei schlecht organisierten kleinen Lieferanten auftreten. Auch größere E-Commerce-Unternehmen können durch jahrelanges Systemwachstum, unterschiedliche Vertriebskanäle und getrennte Datenbanken eine Datenlandschaft entwickeln, in der das glänzende Frontend deutlich konsistenter wirkt als die Infrastruktur dahinter.
Bestandssynchronisierung ist keine administrative Nebensache
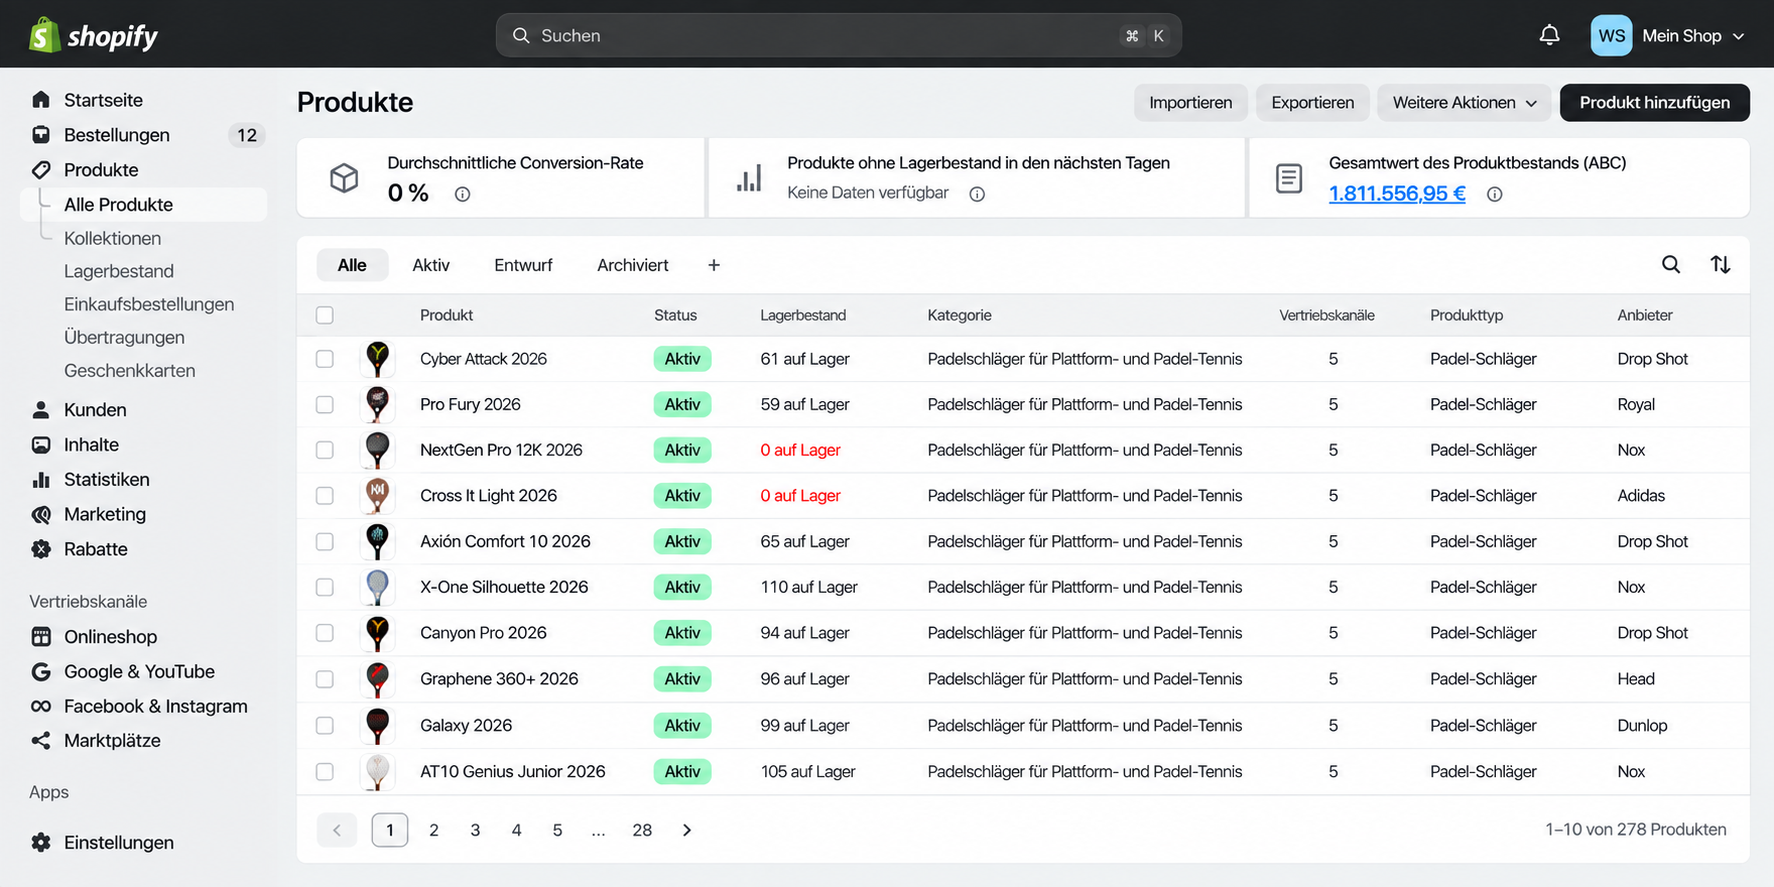
Bestandsmanagement wird noch zu häufig als operativer Prozess behandelt, der vom Marketing getrennt ist. Tatsächlich ist die Verfügbarkeit Bestandteil jedes kommerziellen Versprechens, das ein Onlineshop abgibt. Eine Anzeige kann exakt die richtige Zielgruppe erreichen, eine Produktseite hervorragend konvertieren und der Checkout technisch fehlerfrei funktionieren, doch all diese Optimierungen verlieren ihren Wert, wenn sich nach der Bestellung herausstellt, dass das Produkt nicht geliefert werden kann. Die Werbekosten sind dann bereits entstanden und die Kundenerwartung wurde bereits geweckt, während die eigentliche Transaktion dennoch rückgängig gemacht werden muss.
Damit wirkt sich die Qualität der Bestandsdaten unmittelbar auf Conversion, Kundenservice, Reputation und Kundenwert aus. Eine stornierte Bestellung verursacht nicht nur zusätzliche Arbeit für den Händler, sondern kann auch bedeuten, dass die erste Erfahrung eines neuen Kunden mit der Marke mit einer Enttäuschung beginnt. Wird derselbe Kunde anschließend erneut über Paid Media angesprochen, bezahlt das Unternehmen möglicherweise ein zweites Mal dafür, Vertrauen aufzubauen, das zuvor durch einen falschen Lagerstatus beschädigt wurde. Eine zuverlässige Bestandsverknüpfung ist daher keine administrative Ebene unterhalb des Marketings, sondern eine Voraussetzung dafür, dass Marketing überhaupt wirtschaftlich funktionieren kann.
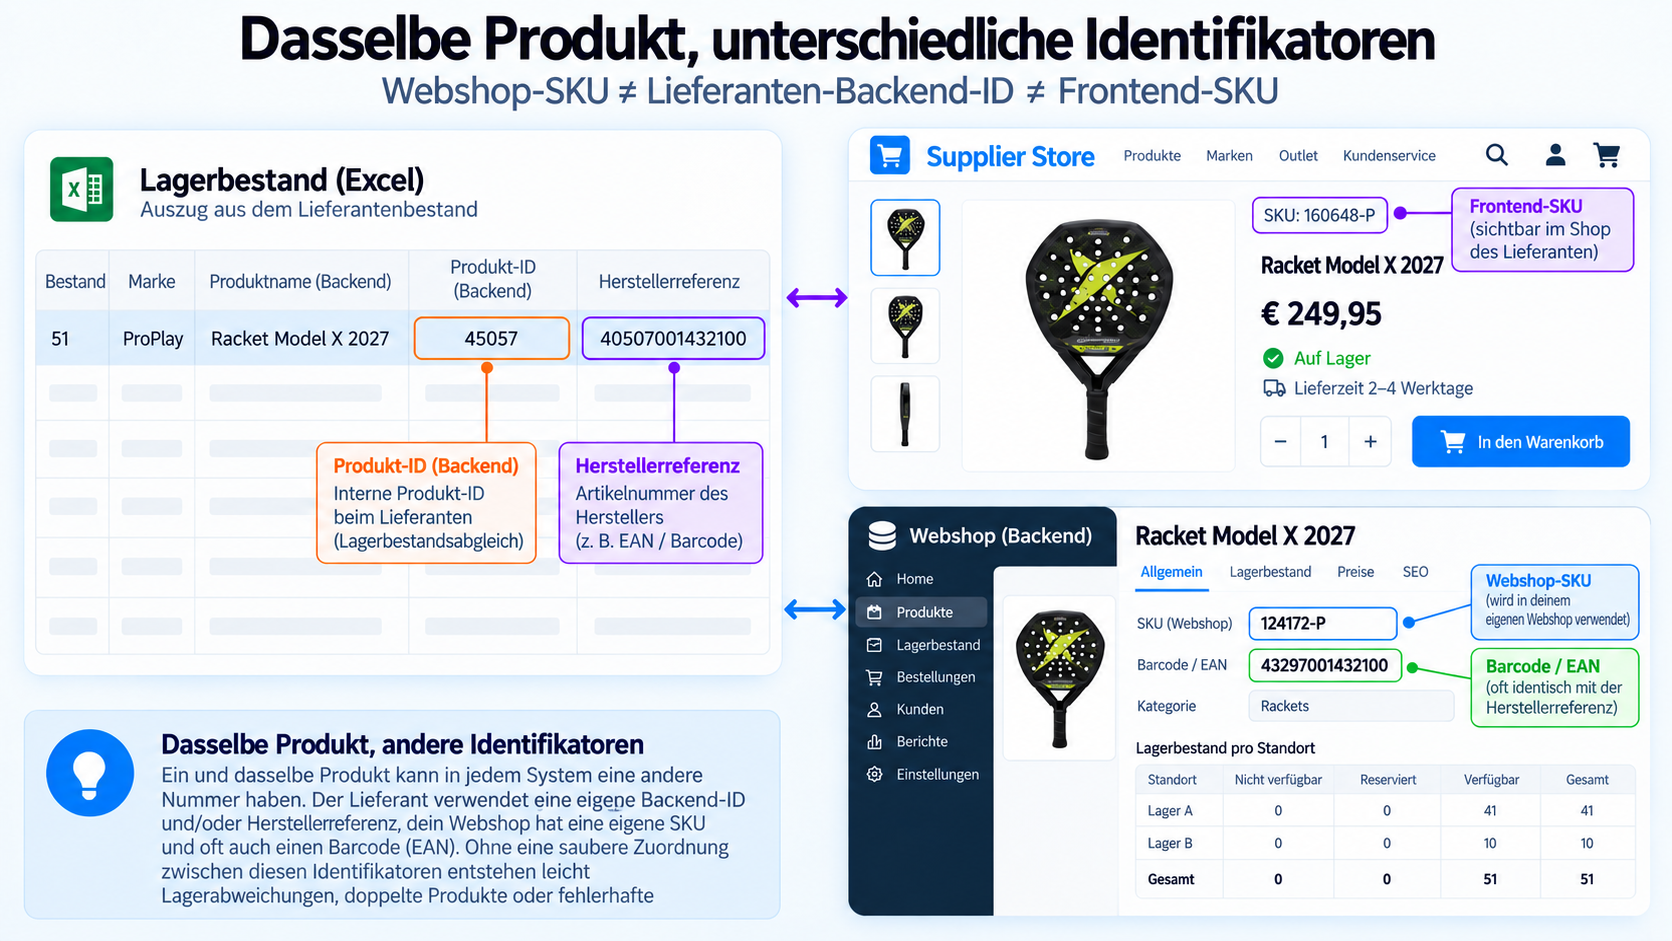
Für eine automatisierte Verknüpfung müssen verschiedene Systeme dasselbe Produkt eindeutig erkennen können. Ein Produktname allein reicht dafür nur selten aus, insbesondere wenn Lieferant und Onlineshop jeweils eigene Namenskonventionen verwenden. In der Praxis muss zumindest klar sein, welche technische Identifikation ein Produkt durch die gesamte Kette begleitet:
- eine SKU oder andere eindeutige Artikelnummer, die in beiden Systemen erkannt werden kann;
- eine EAN oder GTIN, sofern diese verfügbar und zuverlässig ist;
- eine konsistente Verknüpfung zwischen Modell, Ausführung und Variante;
- eine direkte Beziehung zwischen dem identifizierten Artikel und dem tatsächlich verfügbaren B2B-Bestand.
Solange diese Schlüssel übereinstimmen, lässt sich ein großer Teil des Prozesses automatisieren. Sobald jedoch ein System eine andere Identifikation verwendet oder ein wesentlicher Schlüssel vollständig fehlt, wird aus derselben Synchronisierung eine wesentlich komplexere Datenoperation. Dann ist nicht mehr die Geschwindigkeit des Feeds das größte Problem, sondern die Frage, ob beide Systeme überhaupt mit Sicherheit über dasselbe Produkt sprechen. Dieser Unterschied ist entscheidend, denn eine schnelle Verknüpfung mit dem falschen Artikel kann operativ gefährlicher sein als eine langsamere Verknüpfung, die zunächst überprüft wird.
Wenn dasselbe Produkt in zwei Systemen etwas anderes bedeutet
In der Praxis zeigte sich genau an dieser Stelle ein wesentliches Problem. Artikelnummern, die auf der öffentlichen Produktseite des Lieferanten sichtbar waren, fehlten teilweise in den geschäftlichen Daten. Einige Produkte verfügten über eine brauchbare EAN, andere nicht, während sich Produkttitel zwischen Onlineshop und Lieferant in Wortreihenfolge oder Ergänzungen unterschieden. Ein intern nach einer festen Titelstruktur aufgebautes Modell kann auf Lieferantenseite beispielsweise dieselbe Marke und Modellbezeichnung enthalten, jedoch in einer anderen Reihenfolge oder mit einer zusätzlichen kommerziellen Bezeichnung. Für einen Mitarbeiter ist häufig sofort erkennbar, dass beide Datensätze denselben Artikel meinen; für Software ist diese Übereinstimmung keineswegs selbstverständlich.
Eine Excel-Funktion wie XLOOKUP funktioniert hervorragend, wenn beide Dateien einen gemeinsamen konsistenten Schlüssel besitzen, kann jedoch nicht selbstständig erkennen, dass zwei unterschiedlich formulierte Produkttitel semantisch dasselbe Produkt darstellen. Fehlt zusätzlich auf einer Seite die Artikelnummer und steht die EAN nicht durchgängig zur Verfügung, bleibt letztlich nur eine manuelle Mapping-Ebene, in der Hunderte Datensätze einzeln miteinander verknüpft werden müssen. An diesem Punkt wird aus einer scheinbar einfachen Bestandskontrolle Datenmanagement. Nicht weil Excel oder der Onlineshop versagen, sondern weil Automatisierung ohne zuverlässigen Schlüssel keine Sicherheit erzeugen kann.
Eine solche Mapping-Tabelle ist keine elegante Dauerlösung, kann jedoch vorübergehend notwendig sein, um wieder Kontrolle zu erlangen. Jedes korrekt zugeordnete Produkt schafft anschließend eine feste Beziehung zwischen dem eigenen Produktdatensatz und dem Artikel des Lieferanten. Ab diesem Zeitpunkt kann der Bestand wieder automatisiert verarbeitet werden, sofern der Lieferant seine Identifikatoren nicht ändert und neue Modelle nach derselben Struktur ergänzt werden. Der menschliche Aufwand verlagert sich damit von der täglichen manuellen Bestandskontrolle auf die Verwaltung von Ausnahmen und neuen Datensätzen.
Das Risiko entsteht, wenn ein temporäres Mapping so behandelt wird, als hätte es das zugrunde liegende Datenproblem gelöst. Eine falsche Zuordnung wird dann nicht mehr nur einmal manuell vorgenommen, sondern kann bei jeder folgenden Synchronisierung erneut angewendet werden. Automatisierung erhöht schließlich nicht nur die Geschwindigkeit, sondern auch den Umfang, in dem sich ein Fehler verbreiten kann. Bei einem Sortiment mit Hunderten von Modellen reicht eine einzige falsche Beziehung zwischen zwei Datenbanken aus, um ein Produkt dauerhaft mit einem falschen Bestandsstatus zu veröffentlichen.
Automatisierung löst kein Datenproblem. Wenn die Quelldaten nicht eindeutig sind, automatisiert man vor allem die Verbreitung von Fehlern.
Ein Bestandsprozess sollte daher nicht ausschließlich kontrollieren, ob Daten eingelesen werden, sondern auch, warum ein bestimmtes Produkt mit einem bestimmten Lieferantendatensatz verknüpft wurde. Gerade wenn Sortimente wachsen, wird dieser Unterschied wichtiger. Eine Verbindung, die bei fünfzig Produkten noch manuell kontrollierbar ist, kann bei Hunderten oder Tausenden Varianten unbemerkt zu einer strukturellen Fehlerquelle werden. An diesem Punkt ist Datenhygiene keine technische Präferenz mehr, sondern kommerzielles Risikomanagement.
Von verschmutzten Daten zum kommerziellen Risiko
Die einzelnen Probleme wirken isoliert betrachtet manchmal klein. Eine fehlende SKU, ein abweichender Titel oder ein Produkt, das in einem Kanal nicht verfügbar ist, muss für sich genommen noch kein großes operatives Problem darstellen. Die Komplexität entsteht dadurch, dass sich diese Abweichungen gegenseitig verstärken. Ein Produkt mit abweichendem Namen, fehlender EAN und einem anderen Verfügbarkeitsstatus lässt sich ohne zusätzliche Kontrolle nicht mehr zuverlässig zuordnen. Werden dieselben Daten anschließend auch für Bestand, Werbung und Produktfeeds verwendet, wirkt sich ein einzelner Fehler zudem auf mehrere kommerzielle Prozesse aus.
Deshalb ist es sinnvoll, technische Abweichungen nicht nur als Datenproblem zu betrachten, sondern unmittelbar in ihre kommerziellen Folgen zu übersetzen. Ein fehlendes Feld wird erst dann wirklich relevant, wenn deutlich wird, was geschieht, wenn dieses Feld falsch interpretiert wird. Die folgenden Situationen traten während der praktischen Analyse in unterschiedlichen Formen auf und zeigen, warum ein Bestandsfeed niemals ausschließlich anhand seiner technischen Gültigkeit bewertet werden sollte.
| Datenproblem | Technische Folge | Kommerzielles Risiko | Erforderliche Kontrolle |
|---|---|---|---|
| Fehlende SKU | Keine zuverlässige automatische Zuordnung | Falscher Bestandsstatus | Manuelles Mapping oder anderer eindeutiger Schlüssel |
| Fehlende oder abweichende EAN | Produkt nicht eindeutig identifizierbar | Falscher Artikel oder falsche Variante verknüpft | Kontrolle an der Quelle |
| Abweichender Produktname | Text-Matching wird unsicher | Modelle oder Varianten können verwechselt werden | Festes Master-Mapping |
| B2C verfügbar, B2B nicht verfügbar | Öffentlicher Bestand liefert keinen zuverlässigen geschäftlichen Status | Bestellung kann über den Einkaufskanal nicht erfüllt werden | B2B-Verfügbarkeit als führend festlegen |
| Neue Kollektion noch nicht für B2B freigegeben | Artikel fehlt in den regulären Einkaufsdaten | Verzögerter Produktlaunch | Zusätzlichen Händler- oder Launch-Kanal prüfen |
Die letzten beiden Situationen sind besonders interessant, weil sie nicht zwangsläufig auf schlechte Technik zurückzuführen sind. Zwei Systeme können technisch einwandfrei funktionieren und dennoch unterschiedliche kommerzielle Realitäten abbilden. Eine Verbraucherwebsite kann anzeigen, dass ein Produkt verfügbar ist, während derselbe Artikel über das B2B-Konto eines Wiederverkäufers nicht bestellt werden kann. Für den Kunden sieht das wie ein einziger Lagerbestand aus; für den Händler handelt es sich um zwei völlig unterschiedliche Vertriebskanäle mit unterschiedlichen Rechten, Preisen und Konditionen.
Das B2B/B2C-Paradox: sichtbar ist nicht dasselbe wie lieferbar
Dieser Unterschied wurde während der Bestandskontrolle sehr konkret. Bestimmte Artikel waren auf der öffentlichen Verbraucherwebsite des internationalen Lieferanten sichtbar und bestellbar, während sie im geschäftlichen B2B-Portal nicht verfügbar waren oder dort nicht als regulär einkaufbare Artikel erschienen. Wer ausschließlich die öffentliche Website betrachtete, konnte daher vernünftigerweise davon ausgehen, dass Bestand vorhanden war. Aus Sicht des Wiederverkäufers existierte dieser Bestand faktisch jedoch nicht, weil das Produkt über den vereinbarten geschäftlichen Einkaufskanal nicht verfügbar war.
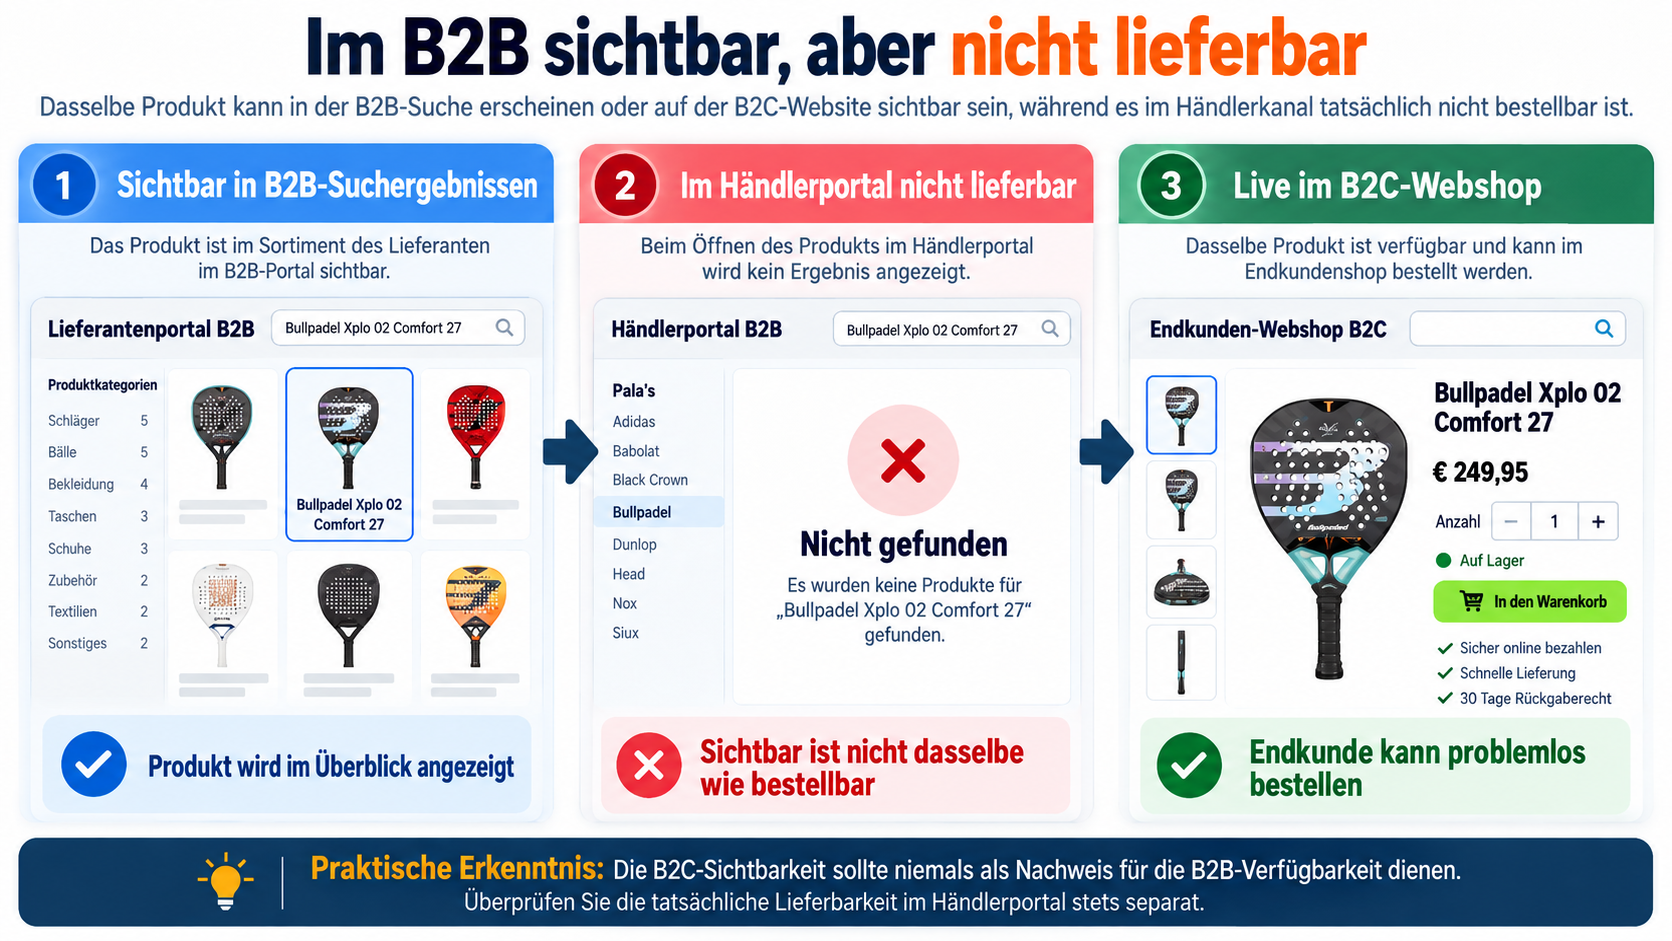
Warum ein Lieferant unterschiedliche Bestandspositionen oder Sortimente je Kanal führt, lässt sich aus einer solchen Beobachtung allein nicht ableiten. Mögliche Erklärungen sind reservierte Bestände, separate Vertriebsvereinbarungen, gestaffelte Produktfreigaben, unterschiedliche Sortimentsfenster oder eine bewusste Kanalstrategie. Für den Onlineshop ändert diese unbekannte Ursache jedoch nichts an der operativen Konsequenz. Die geschäftliche Verfügbarkeit muss dafür maßgeblich sein, was den eigenen Kunden tatsächlich angeboten wird, weil nur dieser Bestand über den vereinbarten Einkaufskanal geliefert werden kann.
Genau deshalb kann das Scrapen eines Consumer-Frontends oder die automatische Übernahme eines allgemeinen öffentlichen Bestandsstatus riskant sein. Die Technologie kann perfekt funktionieren und trotzdem das falsche kommerzielle Signal verarbeiten. Das System erkennt korrekt, dass das Produkt beim Lieferanten verfügbar ist, versteht jedoch nicht, dass diese Verfügbarkeit ausschließlich für Verbraucher gilt und nicht für das B2B-Konto, über das der Händler einkaufen muss. Das Ergebnis sind technisch korrekte Informationen, die kommerziell falsch interpretiert werden.
In einer solchen Situation ist das bewusste Setzen des Lagerbestands auf null keine verpasste Verkaufschance, sondern Risikomanagement. Ein Onlineshop, der einen Artikel vorübergehend als nicht verfügbar kennzeichnet, kann ihn wieder verkaufen, sobald der B2B-Bestand zurückkehrt. Nimmt ein Händler dagegen eine Bestellung an, die anschließend nicht geliefert werden kann, muss er nicht nur erstatten, sondern auch erklären, warum ein als verfügbar dargestelltes Produkt tatsächlich nicht lieferbar war. Damit wandert ein Datenproblem unmittelbar in Kundenservice und Reputation.
Ein Produkt kann technisch verfügbar und kommerziell unverkäuflich sein
Auch eine B2C-Verfügbarkeit schafft noch keinen brauchbaren alternativen Einkaufskanal. Ein Wiederverkäufer kann ein Produkt technisch möglicherweise über die Verbraucherwebsite bestellen, doch damit ist noch nicht belegt, dass diese Transaktion wirtschaftlich sinnvoll ist. Im Verbraucherpreis sind bereits Marge und Retailkosten des Lieferanten enthalten, sodass für einen zweiten Händler meist nur wenig Spielraum bleibt. Soll dasselbe Produkt anschließend zu einem wettbewerbsfähigen Marktpreis angeboten werden, müssen aus diesem verbleibenden Spielraum zusätzlich die eigenen Kosten finanziert werden.
Dabei geht es nicht nur um die einfache Differenz zwischen Einkaufs- und Verkaufspreis. Mehrwertsteuer, Versand, Zahlungsanbietergebühren, Plattformkosten, Marketingausgaben, Kundenservice und Retourenrisiko bestimmen gemeinsam, ob ein Produkt wirtschaftlich verantwortbar verkauft werden kann. Gerade bei Produkten mit relativ hohen Retourenkosten kann eine theoretisch positive Bruttomarge in der Praxis dennoch zu gering sein, um das Verkaufsrisiko zu rechtfertigen. Verfügbarkeit muss deshalb mindestens zwei Fragen beantworten: Kann das Produkt tatsächlich eingekauft werden und kann es anschließend wirtschaftlich vertretbar weiterverkauft werden?
Ein Produkt ist für einen Händler erst dann wirklich verfügbar, wenn es sowohl lieferbar als auch wirtschaftlich sinnvoll einkaufbar ist.
Dieser Unterschied wird leicht übersehen, wenn Produktdaten und Marketing getrennt von der finanziellen Logik verwaltet werden. Ein Marketer sieht ein beliebtes Modell und möchte es so schnell wie möglich auffindbar machen, ein Feed-Manager sieht eine URL mit ausgewiesenem Bestand und der Kunde sieht letztlich einen Kaufbutton. Erst wenn jemand die gesamte Kette betrachtet, wird sichtbar, dass der Verkauf desselben Produkts zum aktuellen Marktpreis möglicherweise kaum Spielraum für die Kosten lässt, die zwischen Bestellung und Lieferung entstehen. Technische Verfügbarkeit ist daher kein Synonym für kommerzielle Verfügbarkeit.
Neue Kollektionen zeigen, wo die Supply Chain das Marketing überholt
Bei neuen Produktkollektionen verschärft sich das Problem weiter. Während derselben Sortimentsanalyse waren Modelle aus einer neuen Kollektion bereits auf der Verbraucherwebsite des Lieferanten und bei verschiedenen Wettbewerbern sichtbar, während sie über den regulären geschäftlichen Kanal noch nicht oder nur eingeschränkt verfügbar waren. Das ist kein klassischer Bestandsfehler. Der B2B-Feed kann vollkommen korrekt anzeigen, dass das eigene Konto den Artikel noch nicht bestellen kann, während andere Marktteilnehmer das Produkt bereits aktiv verkaufen.
Für einen spezialisierten Onlineshop entsteht dadurch ein strategischer Rückstand, der nicht durch eine schnellere Synchronisierung gelöst werden kann. Wettbewerber können ihre Produktseiten früher indexieren lassen, Anzeigen aktivieren, Bewertungen sammeln und die erste Suchnachfrage nach einem neuen Modell abfangen. Gibt der eigene B2B-Kanal das Produkt erst später frei, beginnt die kommerzielle Markteinführung schlicht nicht zum selben Zeitpunkt. In diesem Fall bestimmt die Supply Chain buchstäblich, wann Marketing beginnen kann.
[BILD 4 – anonymisierter Screenshot einer neuen Kollektion oder Modellreihe, die in einem Verbraucher- oder Marktumfeld bereits sichtbar ist, während die reguläre geschäftliche B2B-Einkaufsverfügbarkeit noch fehlt oder eingeschränkt ist. Unternehmens- und Lieferantenidentifikation entfernen; die Launch-Lücke selbst sichtbar lassen.]
Das bedeutet nicht, dass ein bestehender Hauptlieferant dadurch ungeeignet wird. Für etablierte Modelle kann derselbe Lieferant gerade attraktive B2B-Preise, breite Verfügbarkeit und operative Einfachheit bieten. Es entsteht jedoch ein Grund, Produktlaunches als eigene Einkaufskategorie zu behandeln. Der beste Lieferant für ein etabliertes Sortiment ist nicht automatisch auch der beste Weg in den ersten Wochen einer neuen Kollektion.
Für neue Produktlaunches sollte ein Händler deshalb gesondert beurteilen:
- wann die tatsächliche geschäftliche Händlerfreigabe beginnt;
- welche neuen Modelle kommerziell wichtig genug sind, um früh verfügbar zu sein;
- ob für Launches ein zusätzlicher Distributor oder eine direkte Händlerbeziehung erforderlich ist;
- wann der reguläre B2B-Einkauf attraktiver wird als frühe Verfügbarkeit.
Ein kleiner oder mittelgroßer spezialisierter Onlineshop muss dafür nicht sofort jede neue Kollektion vollständig auf Lager nehmen. Es kann genügen, zum Marktstart eine begrenzte Anzahl von Modellen auszuwählen, für die nachweisbare Nachfrage besteht, während der Rest später über den regulären B2B-Kanal ergänzt wird. Dadurch wird die Lieferantenstruktur nicht unnötig komplex, gleichzeitig wird jedoch verhindert, dass ein einzelner Vertriebskanal automatisch den Markteinführungszeitpunkt des gesamten Sortiments bestimmt.
Der Produktfeed ist nicht der Anfang der Kette
Viele Diskussionen über E-Commerce-Integration beginnen mit der Frage, wie ein Produktfeed eingerichtet werden sollte. Das ist verständlich, weil der Feed die sichtbare technische Verbindung zwischen Systemen bildet. Kommerziell beginnt der Prozess jedoch deutlich früher. Bevor ein Artikel sicher über einen Feed verteilt werden kann, müssen Produktidentität, Quelldaten, geschäftliche Verfügbarkeit, Einkaufspreis und Marge bereits mit ausreichender Zuverlässigkeit geklärt sein.
Ein technisch perfekter Feed kann keine fehlende Artikelnummer rekonstruieren, die der Lieferant selbst nicht konsistent veröffentlicht. Ebenso wenig kann er feststellen, dass B2C-Bestand für ein bestimmtes Konto geschäftlich nicht verfügbar ist, sofern diese Logik nicht ausdrücklich in den Daten oder einer Zwischenschicht hinterlegt wird. Ein Bestandsfeed kann außerdem nicht selbstständig beurteilen, ob ein Produkt mit einem bestimmten Einkaufspreis noch genügend Marge bietet, nachdem Mehrwertsteuer, Versand und Retourenrisiko berücksichtigt wurden. Solche Entscheidungen liegen vor der Verteilung der Daten.
Die Qualität einer E-Commerce-Integration hängt deshalb nicht nur von APIs, CSV-Dateien oder der Synchronisierungsfrequenz ab. Mindestens ebenso wichtig ist die Qualität des Datenmodells, mit dem Ausnahmen verwaltet werden. Welche Quelle ist führend, wenn sich zwei Systeme widersprechen? Welche Produkte dürfen niemals automatisch ohne geschäftlichen Bestand aktiviert werden? Welche neuen Modelle benötigen zunächst eine Margenprüfung und wie verhindert man, dass eine manuell korrigierte Ausnahme beim nächsten Import wieder überschrieben wird?
Erst wenn diese Fragen beantwortet sind, entfaltet Automatisierung ihren eigentlichen Wert. Dann übernimmt sie repetitive Arbeit zuverlässig, anstatt Unsicherheit schneller durch die Kette zu verbreiten. Dieser Unterschied ist grundlegend für jeden Onlineshop, der von externen Lieferanten abhängig ist und Hunderte Produkte verwaltet. Skalierbarkeit entsteht nicht dadurch, dass möglichst viel automatisiert wird, sondern dadurch, dass klar ist, welche Daten zuverlässig genug sind, um ohne menschliches Eingreifen automatisiert verarbeitet zu werden.
Marketingexpertise endet nicht an der Vorderseite des Onlineshops
Diese Praxisfallstudie zeigt zugleich eine breitere Einschränkung darin, wie digitales Marketing häufig abgegrenzt wird. Das Fach wird leicht auf Kampagnenplattformen, Content, Dashboards und Conversion-Optimierung reduziert. Das sind sichtbare Bereiche, in denen Ergebnisse relativ einfach berichtet werden können, im E-Commerce stellen sie jedoch nur einen Teil des kommerziellen Systems dar. Eine Kampagne, die Umsatz für ein Produkt generiert, das anschließend nicht lieferbar ist, kann innerhalb der Werbeplattform erfolgreich erscheinen und für das Unternehmen insgesamt dennoch scheitern.
Das bedeutet nicht, dass jeder Marketer selbst APIs programmieren, Bestandsdateien bereinigen oder internationale Einkaufsverträge verwalten muss. Von jemandem, der Verantwortung für E-Commerce trägt, darf jedoch erwartet werden, dass er versteht, wie diese Bestandteile die Marketingleistung begrenzen. Eine steigende Conversion Rate sagt wenig aus, wenn gleichzeitig mehr Bestellungen storniert werden müssen. Ein Produktfeed mit hundert Prozent technisch gültigen Feldern ist ebenso wenig zuverlässig, wenn die zugrunde liegende Bestandsquelle kommerziell falsch interpretiert wird.
Genau hier entsteht der Unterschied zwischen dem Bedienen von Marketingtools und dem Verständnis des Systems, in dem diese Tools funktionieren. Die Technik muss nicht vollständig von einer Person ausgeführt werden, doch jemand muss erkennen können, wann ein Problem außerhalb der Werbeplattform entsteht und welche Disziplin erforderlich ist, um es zu lösen. Manchmal liegt die Ursache in Produktdaten, manchmal in der Bestandssegmentierung, manchmal in der Marge und manchmal in der Struktur der Lieferantenbeziehung. Wer nur auf die Vorderseite blickt, sieht die Symptome erst, nachdem der Kunde damit konfrontiert wurde.
Für Unternehmen, die E-Commerce skalieren möchten, ist das keine theoretische Nuance. Mit wachsendem Sortiment, zusätzlichen Ländern, Lieferanten und Vertriebskanälen steigt die Zahl der Abhängigkeiten schneller als die Zahl der sichtbaren Seiten im Onlineshop. Eine manuelle Ausnahme, die bei hundert Produkten noch beherrschbar ist, kann bei tausend Produkten zu einer strukturellen Fehlerquelle werden. Skalierbarkeit beginnt deshalb nicht ausschließlich mit mehr Traffic oder mehr Automatisierung, sondern mit einem Datenmodell und einer Supply Chain, die dem zusätzlichen kommerziellen Druck standhalten können.
Der Kunde bemerkt letztlich jeden Fehler in der Kette
Der Kunde muss nichts über SKUs, EAN-Codes, Mapping-Tabellen, B2B-Portale oder Bestandsfeeds wissen. Das ist auch nicht seine Verantwortung. Er sieht ein Produkt, erhält ein Verfügbarkeitsversprechen und erwartet anschließend, dass die Bestellung ausgeführt wird. Genau deshalb muss die Komplexität hinter den Kulissen vor dem Kaufbutton gelöst werden und nicht danach.
Für Marketer und E-Commerce-Professionals ist das möglicherweise die wichtigste Erkenntnis aus diesem Praxisfall. Datenqualität ist kein rein internes technisches Thema, solange schlechte Daten bestimmen, welche Produkte beworben, verkauft oder storniert werden. Lieferantenstrategie ist kein reines Einkaufsthema, wenn der gewählte Vertriebsweg darüber entscheidet, ob eine neue Kollektion Wochen früher oder später auf den Markt gebracht werden kann. Und Bestandsmanagement ist keine Backoffice-Aktivität, wenn ein falscher Status unmittelbar Kundenvertrauen, Akquisitionskosten und Marge beeinflusst.
Die Vorderseite des E-Commerce bestimmt, wie überzeugend ein Produkt präsentiert und verkauft wird. Die Rückseite bestimmt, ob dieses kommerzielle Versprechen tatsächlich eingehalten werden kann. Wer nur Werbung, Content und Conversion optimiert, ohne die Qualität von Produktdaten, Bestand und Einkaufskonditionen einzubeziehen, optimiert letztlich nur einen Teil des Systems. Mehr noch: Je besser das Marketing funktioniert, desto schneller wird eine schwache Supply Chain sichtbar, wenn zusätzliche Nachfrage nicht zuverlässig erfüllt werden kann.
Die ausgereifteste Form des E-Commerce-Marketings beginnt deshalb nicht mit der Frage, wie viel zusätzlichen Traffic eine Kampagne erzeugen kann, sondern mit einer grundlegenderen Kontrolle: Kann die Organisation die Nachfrage, die sie selbst erzeugt, zuverlässig, profitabel und ohne unnötige Reibung erfüllen? Erst wenn Produktdaten, geschäftliche Verfügbarkeit, Marge und Lieferung aufeinander abgestimmt sind, erhält das Marketing an der Vorderseite den Wert, den Dashboards ihm zuschreiben.


