
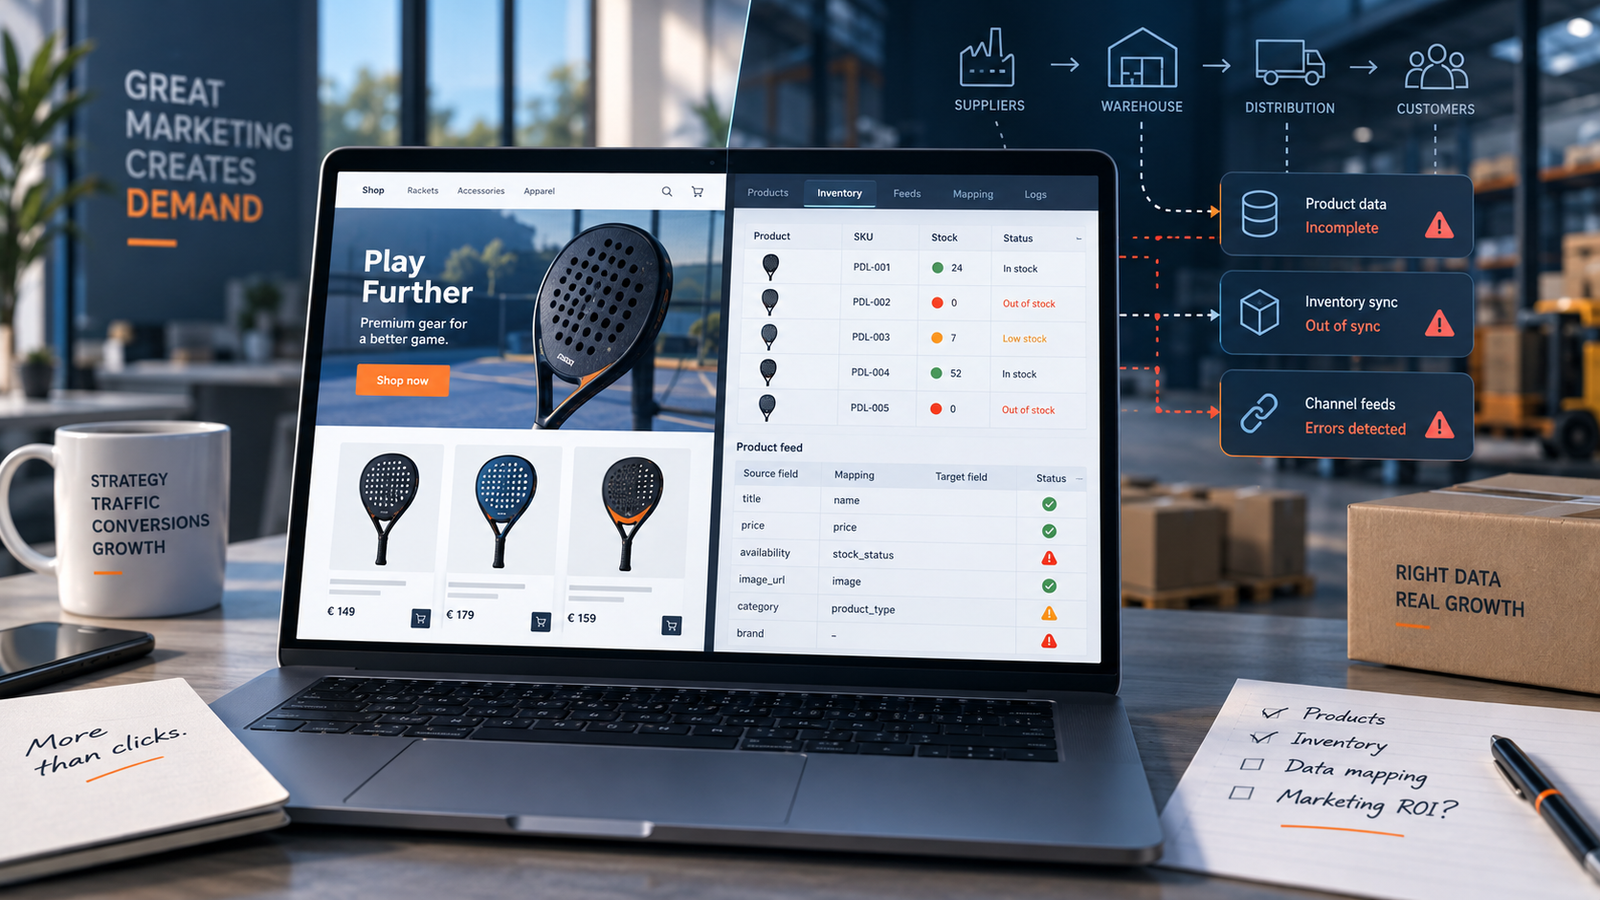
Achter de schermen van e-commerce: waarom marketing faalt als de supply chain rammelt
In e-commerce gaat opvallend veel aandacht naar wat de klant ziet. We optimaliseren advertenties, productpagina’s, customer journeys, checkoutflows en conversiepercentages, terwijl dashboards steeds nauwkeuriger laten zien waar bezoekers afhaken en welke campagne omzet genereert. Dat werk is belangrijk, maar het vertegenwoordigt slechts de voorkant van het commerciële systeem. Achter iedere klik bevindt zich een veel minder zichtbare keten van productdata, voorraad, leveranciers, inkoopvoorwaarden en systeemkoppelingen. Wanneer die achterkant niet betrouwbaar functioneert, kan sterke marketing het probleem zelfs vergroten doordat zij extra vraag creëert naar producten die niet of niet verantwoord geleverd kunnen worden.
Dat werd onlangs opnieuw zichtbaar tijdens een voorraad- en data-operatie voor een gespecialiseerde Nederlandse webshop in hoogwaardige sportuitrusting. Het assortiment bestaat uit meer dan vierhonderd modellen en varianten die voor een belangrijk deel afhankelijk zijn van een internationale hoofdleverancier. Voor zo’n assortiment is actuele voorraad geen administratief detail. Wanneer een klant een specifiek model bestelt dat volgens de webshop beschikbaar is maar via het zakelijke inkoopkanaal inmiddels niet meer geleverd kan worden, eindigt een succesvolle conversie alsnog in een annulering, terugbetaling en teleurgestelde klant. De e-commerce supply chain bepaalt daarmee rechtstreeks of de commerciële belofte aan de voorkant daadwerkelijk kan worden waargemaakt.
Wat in eerste instantie een reguliere synchronisatie van voorraadgegevens leek, maakte zichtbaar hoeveel verschillende systemen achter één ogenschijnlijk eenvoudige voorraadstatus schuilgaan. Productnamen bleken niet overal identiek, unieke artikelnummers waren niet in iedere databron beschikbaar, EAN-codes sloten niet altijd aan en de publieke consumentenwebsite van de leverancier liet soms een andere commerciële werkelijkheid zien dan het zakelijke B2B-portaal. Dat zijn geen exotische uitzonderingen die alleen bij slecht georganiseerde kleine leveranciers voorkomen. Ook grotere e-commerceorganisaties kunnen door jaren van systeemgroei, verschillende verkoopkanalen en afzonderlijke databases een datalandschap hebben waarin de glanzende frontend veel consistenter oogt dan de infrastructuur erachter.
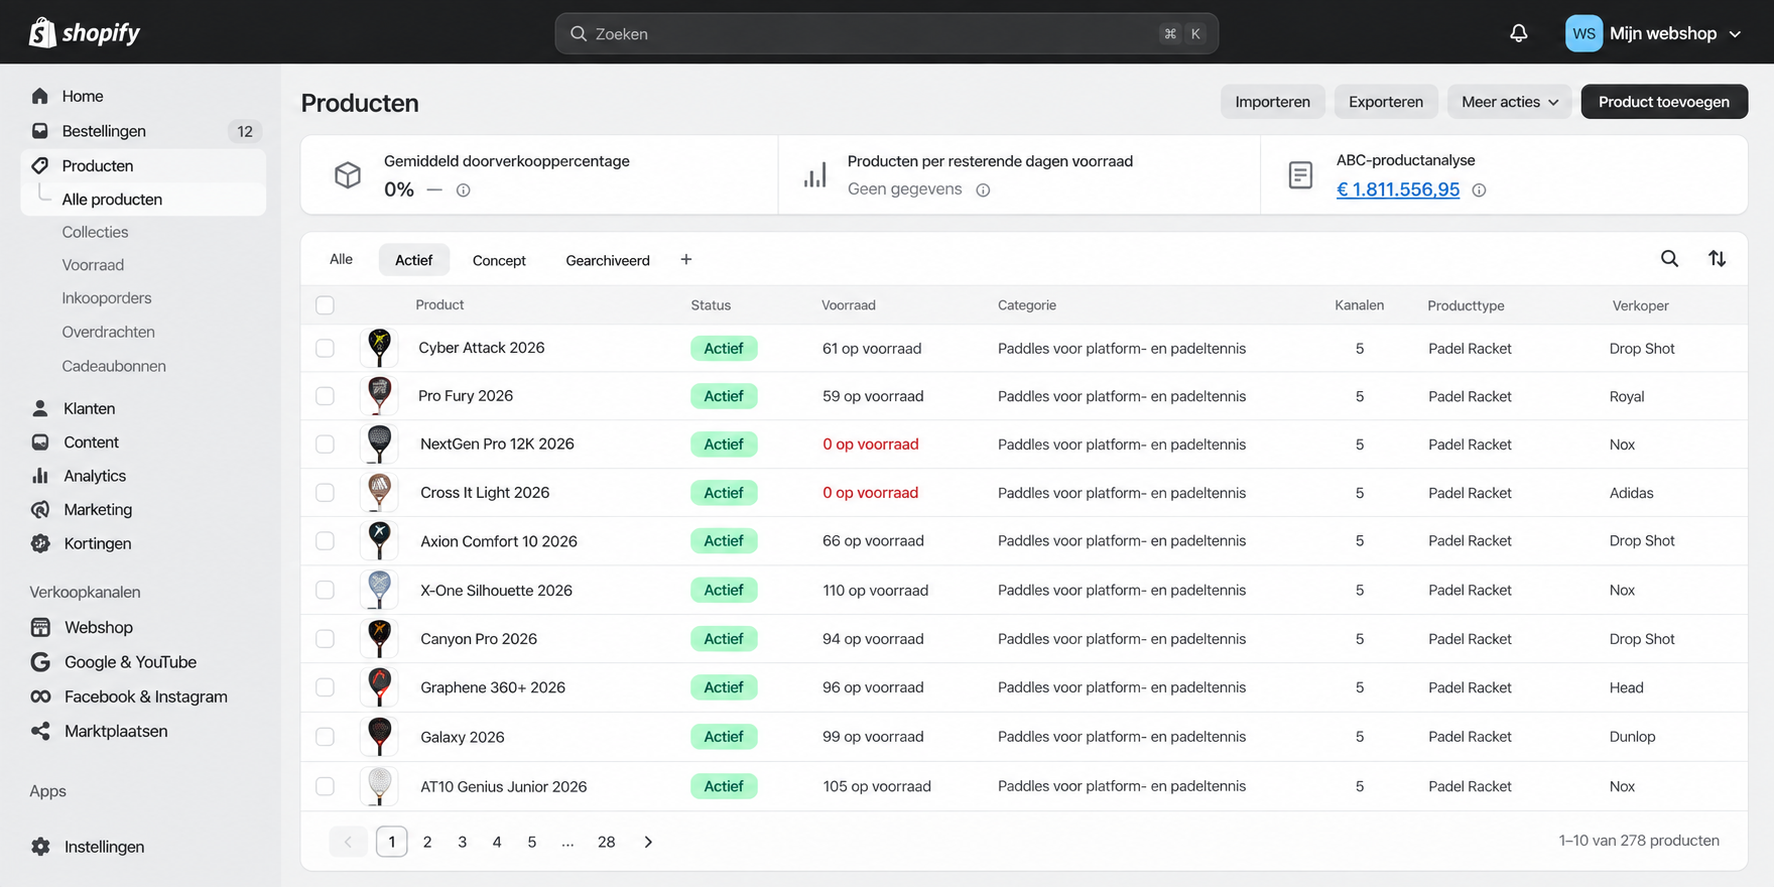
Voorraadsynchronisatie is geen administratieve bijzaak
Voorraadbeheer wordt nog te vaak behandeld als een operationeel proces dat losstaat van marketing. In werkelijkheid vormt beschikbaarheid een onderdeel van iedere commerciële belofte die een webshop doet. Een advertentie kan precies de juiste doelgroep bereiken, een productpagina kan uitstekend converteren en de checkout kan technisch foutloos functioneren, maar al die optimalisaties verliezen hun waarde wanneer het product na bestelling niet geleverd blijkt te kunnen worden. De advertentiekosten zijn dan wel gemaakt en de klantverwachting is wel gewekt, terwijl de daadwerkelijke transactie alsnog moet worden teruggedraaid.
Dat maakt voorraadkwaliteit rechtstreeks relevant voor conversie, klantenservice, reputatie en klantwaarde. Een geannuleerde bestelling levert niet alleen extra handelingen op voor de ondernemer, maar kan ook betekenen dat een nieuwe klant zijn eerste ervaring met het merk begint met een teleurstelling. Wie dezelfde klant vervolgens opnieuw via betaalde media probeert te bereiken, betaalt mogelijk nogmaals voor vertrouwen dat eerder door een onjuiste voorraadstatus is beschadigd. Een betrouwbare voorraadkoppeling is daarom niet de administratieve laag onder marketing, maar een voorwaarde waaronder marketing überhaupt economisch kan functioneren.
Voor een geautomatiseerde koppeling moeten verschillende systemen hetzelfde product ondubbelzinnig kunnen herkennen. Een productnaam alleen is daarvoor zelden voldoende, zeker wanneer leverancier en webshop ieder hun eigen naamconventies hanteren. In de praktijk moet minimaal duidelijk zijn welke technische identificatie een product door de volledige keten volgt:
- een SKU of ander uniek artikelnummer dat in beide systemen herkenbaar is;
- een EAN- of GTIN-code waar deze beschikbaar en betrouwbaar is;
- een consistente koppeling tussen model, uitvoering en variant;
- een directe relatie tussen het geïdentificeerde artikel en de daadwerkelijke B2B-voorraad.
Zolang die sleutels overeenkomen, kan een groot deel van het proces worden geautomatiseerd. Zodra één systeem echter een andere identificatie hanteert of een essentiële sleutel helemaal niet bevat, verandert dezelfde synchronisatie in een veel complexere data-operatie. Dan is niet langer de snelheid van de feed het grootste probleem, maar de vraag of beide systemen überhaupt met zekerheid over hetzelfde product spreken. Dat onderscheid is essentieel, omdat een snelle koppeling naar het verkeerde artikel operationeel gevaarlijker kan zijn dan een langzamere koppeling die eerst wordt gecontroleerd.
Wanneer hetzelfde product in twee systemen iets anders betekent
In de praktijk bleek precies daar een belangrijk knelpunt te zitten. Artikelnummers die op de publieke productpagina van de leverancier zichtbaar waren, ontbraken in delen van de zakelijke data. Sommige producten beschikten over een bruikbare EAN-code, andere niet, terwijl producttitels tussen webshop en leverancier in woordvolgorde of toevoegingen verschilden. Een model dat intern volgens één vaste titelconstructie is opgebouwd, kan aan leverancierszijde bijvoorbeeld dezelfde merknaam en modelnaam bevatten, maar in een andere volgorde of met een extra commerciële aanduiding. Voor een medewerker is vaak direct herkenbaar dat het om hetzelfde artikel gaat, maar voor software is die overeenkomst niet vanzelfsprekend.
Een Excel-functie als XLOOKUP werkt uitstekend wanneer beide bestanden één consistente sleutel delen, maar kan niet zelfstandig bepalen dat twee afwijkende titels semantisch hetzelfde product vertegenwoordigen. Wanneer bovendien het artikelnummer aan één kant ontbreekt en de EAN-code niet consequent beschikbaar is, resteert uiteindelijk een handmatige mappinglaag waarin honderden records één voor één aan elkaar moeten worden gekoppeld. Dat is het punt waarop een ogenschijnlijk eenvoudige voorraadcontrole verandert in datamanagement. Niet omdat Excel of de webshop tekortschiet, maar omdat automatisering zonder betrouwbare sleutel geen zekerheid kan produceren.
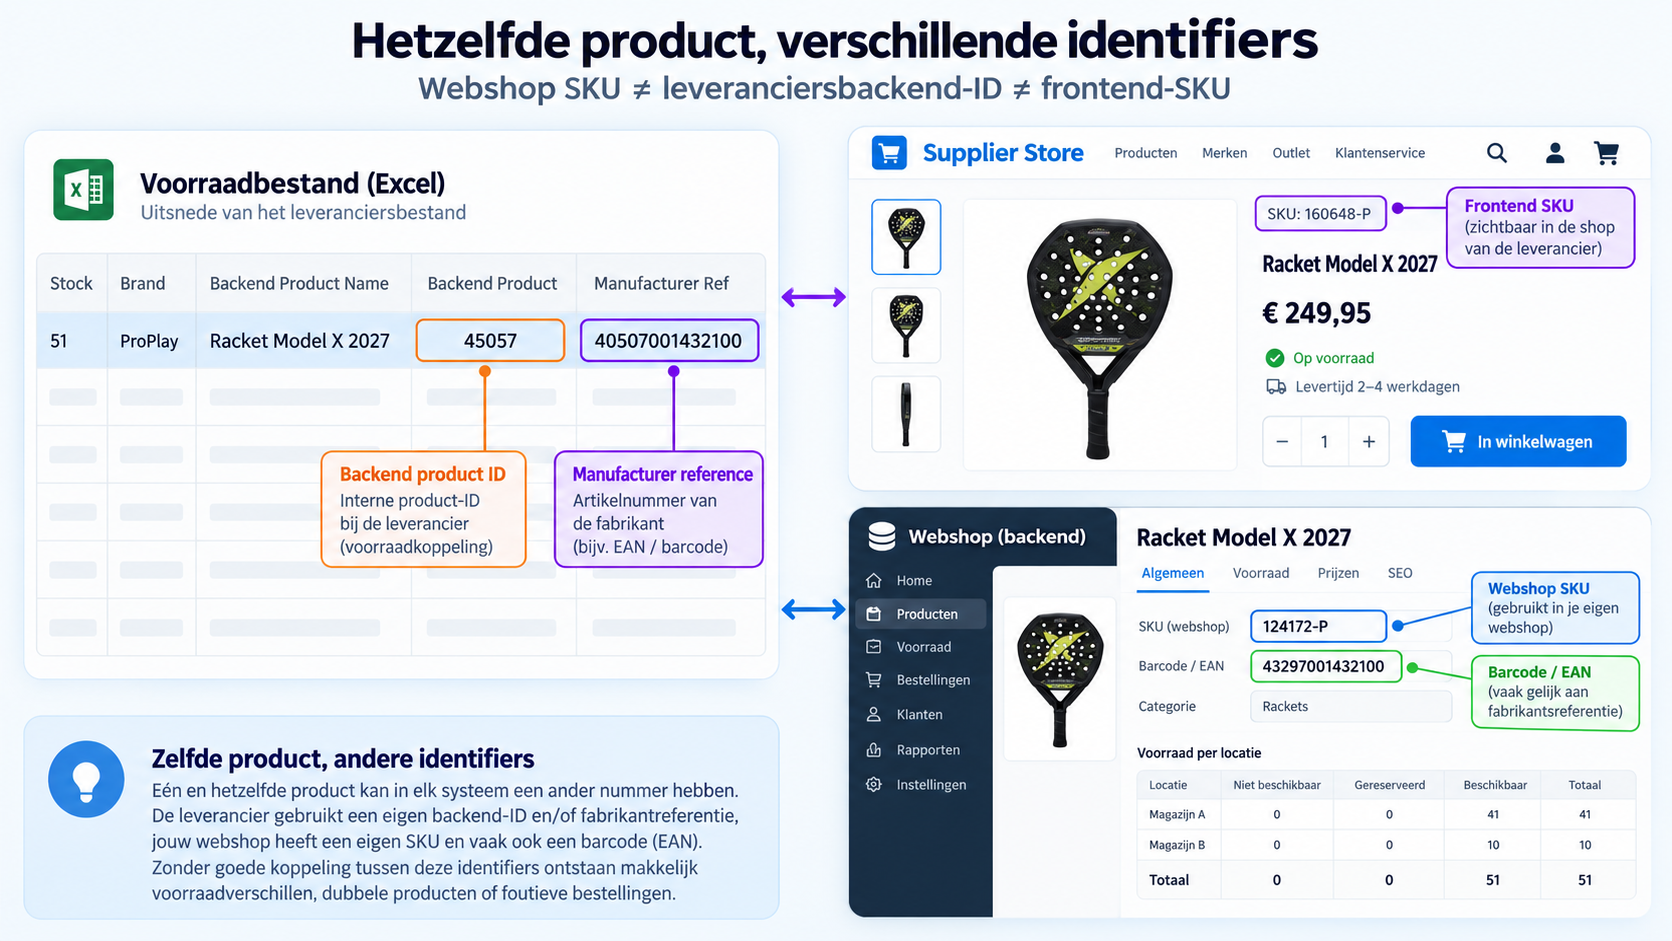
Zo’n mappingtabel is geen elegante eindoplossing, maar kan tijdelijk noodzakelijk zijn om controle terug te krijgen. Ieder correct gekoppeld product vormt daarna een vaste relatie tussen het eigen productrecord en het artikel van de leverancier. Vanaf dat moment kan voorraad opnieuw geautomatiseerd worden verwerkt, mits de leverancier zijn identificatie niet verandert en nieuwe modellen volgens dezelfde structuur worden toegevoegd. De menselijke inspanning verschuift daarmee van dagelijks handmatig voorraad controleren naar het beheren van uitzonderingen en nieuwe records.
Het risico ontstaat wanneer een tijdelijke mapping wordt behandeld alsof zij het onderliggende dataprobleem heeft opgelost. Een verkeerde koppeling wordt dan niet langer één keer handmatig gemaakt, maar kan iedere volgende synchronisatie opnieuw worden toegepast. Automatisering vergroot immers niet alleen snelheid; zij vergroot ook de schaal waarop een fout zich kan verspreiden. Bij een assortiment van honderden modellen is één onjuiste relatie tussen twee databases voldoende om een product structureel met de verkeerde voorraadstatus te blijven publiceren.
Automatisering lost een dataprobleem niet op. Als de brondata niet eenduidig zijn, automatiseer je vooral de verspreiding van fouten.
Daarom hoort een voorraadproces niet uitsluitend te controleren óf data worden ingelezen, maar ook waarom een bepaald product aan een bepaald leveranciersrecord is gekoppeld. Juist wanneer assortimenten groeien, wordt dat onderscheid belangrijk. Een koppeling die met vijftig producten nog handmatig te controleren valt, kan bij honderden of duizenden varianten ongemerkt een structurele foutbron worden. Dat is het moment waarop datahygiëne geen technische voorkeur meer is, maar commercieel risicobeheer.
Van datavervuiling naar commercieel risico
De verschillende problemen lijken afzonderlijk soms klein. Een ontbrekende SKU, een afwijkende titel of een product dat in één kanaal niet beschikbaar is, hoeft op zichzelf geen groot operationeel probleem te zijn. De complexiteit ontstaat doordat deze afwijkingen elkaar versterken. Een product met een afwijkende naam én ontbrekende EAN én een andere beschikbaarheidsstatus kan niet meer betrouwbaar worden gekoppeld zonder aanvullende controle. Zodra dezelfde data vervolgens wordt gebruikt voor voorraad, advertenties en productfeeds, werkt één fout bovendien door in meerdere commerciële processen.
Het helpt daarom om technische afwijkingen niet alleen als dataprobleem te bekijken, maar direct te vertalen naar hun commerciële consequentie. Een ontbrekend veld is pas echt relevant wanneer duidelijk wordt wat er gebeurt wanneer dat veld verkeerd wordt geïnterpreteerd. De onderstaande situaties kwamen tijdens de praktijkanalyse in verschillende vormen terug en laten zien waarom een voorraadfeed nooit alleen op technische geldigheid mag worden beoordeeld.
| Dataprobleem | Technisch gevolg | Commercieel risico | Benodigde controle |
|---|---|---|---|
| Ontbrekende SKU | Geen betrouwbare automatische match | Verkeerde voorraadstatus | Handmatige mapping of andere unieke sleutel |
| Ontbrekende of afwijkende EAN | Product niet eenduidig herkenbaar | Verkeerd artikel of variant gekoppeld | Controle aan de bron |
| Afwijkende productnaam | Tekstmatching wordt onzeker | Modellen of varianten kunnen worden verwisseld | Vaste master mapping |
| B2C beschikbaar, B2B niet beschikbaar | Publieke voorraad geeft geen betrouwbare zakelijke status | Bestelling kan via het inkoopkanaal niet worden geleverd | B2B-beschikbaarheid leidend maken |
| Nieuwe collectie nog niet B2B vrijgegeven | Artikel ontbreekt in de reguliere inkoopdata | Achterstand bij productintroductie | Aanvullende dealer- of launchroute beoordelen |
De laatste twee situaties zijn bijzonder interessant omdat ze niet noodzakelijk door slechte techniek worden veroorzaakt. Twee systemen kunnen technisch allebei correct functioneren en toch verschillende commerciële werkelijkheden tonen. Een consumentenwebsite kan aangeven dat een product beschikbaar is, terwijl hetzelfde artikel via het zakelijke account van een wederverkoper niet besteld kan worden. Voor de klant oogt dat als één voorraadpositie; voor de retailer zijn het twee volledig verschillende verkoopkanalen met verschillende rechten, prijzen en voorwaarden.
De B2B/B2C-paradox: zichtbaar is niet hetzelfde als leverbaar
Dat onderscheid werd tijdens de voorraadcontrole zeer concreet. Bepaalde artikelen waren op de publieke consumentenwebsite van de internationale leverancier zichtbaar en bestelbaar, terwijl ze in het zakelijke B2B-portaal niet beschikbaar waren of daar niet terugkwamen als regulier inkoopbaar artikel. Wie uitsluitend naar de publieke webshop zou kijken, kon dus redelijkerwijs concluderen dat er voorraad aanwezig was. Vanuit het perspectief van de wederverkoper bestond die voorraad echter feitelijk niet, omdat het product via het overeengekomen zakelijke kanaal niet beschikbaar was.
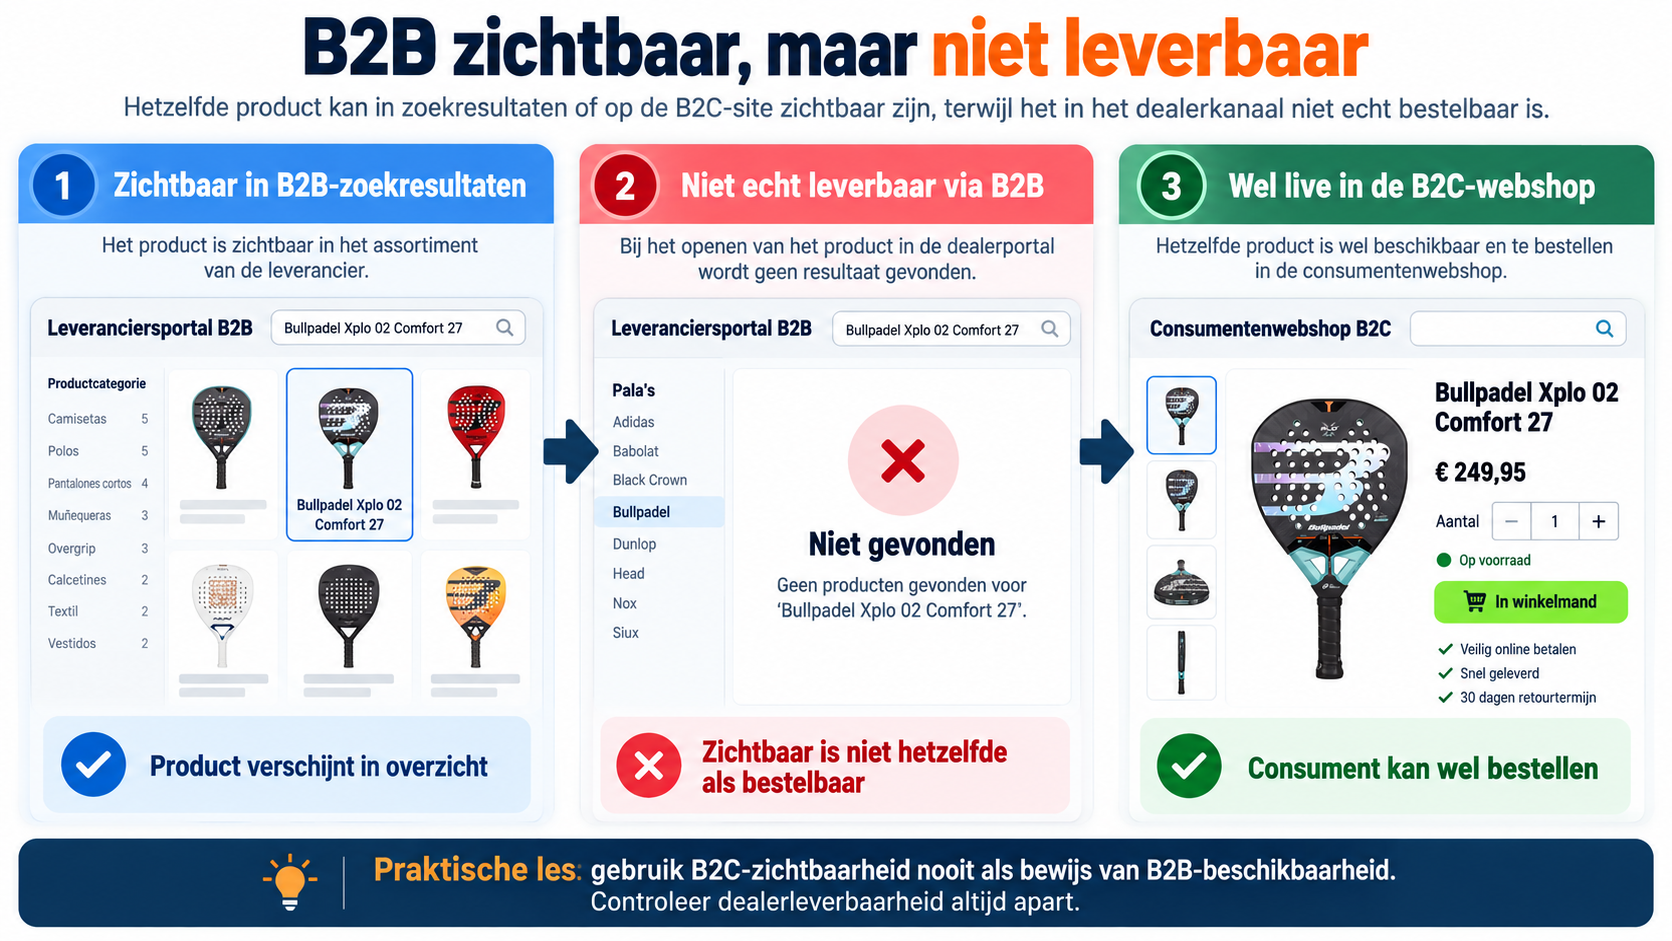
Waarom een leverancier verschillende voorraadposities of assortimenten per kanaal hanteert, kan niet uitsluitend uit zo’n observatie worden afgeleid. Mogelijke verklaringen zijn gereserveerde voorraad, afzonderlijke distributieafspraken, gefaseerde releases, verschillende assortimentsvensters of een bewuste kanaalstrategie. Voor de webshop verandert die onbekende oorzaak echter niets aan de operationele consequentie. De zakelijke beschikbaarheid moet leidend zijn voor wat daadwerkelijk aan de eigen klant wordt aangeboden, omdat alleen die voorraad via de overeengekomen inkooproute kan worden geleverd.
Dat is ook waarom het scrapen van een consumentenfrontend of het automatisch overnemen van een algemene publieke voorraadstatus riskant kan zijn. De technologie kan perfect functioneren en toch het verkeerde commerciële signaal verwerken. Het systeem leest dan correct dat het product bij de leverancier beschikbaar is, maar begrijpt niet dat die beschikbaarheid uitsluitend voor consumenten geldt en niet voor het zakelijke account waarmee de webshop moet inkopen. Het resultaat is technisch correcte informatie die commercieel onjuist wordt geïnterpreteerd.
In zo’n situatie is bewust een voorraadpositie op nul zetten geen gemiste verkoopkans, maar risicobeheersing. Een webshop die tijdelijk aangeeft dat een artikel niet beschikbaar is, kan later opnieuw verkopen zodra de zakelijke voorraad terugkeert. Een webshop die een bestelling aanneemt die vervolgens niet kan worden geleverd, moet niet alleen terugbetalen maar ook uitleggen waarom een product dat als beschikbaar werd gepresenteerd in werkelijkheid niet leverbaar was. Daarmee verschuift een dataprobleem rechtstreeks naar klantenservice en reputatie.
Een product kan technisch beschikbaar en commercieel onverkoopbaar zijn
Ook B2C-beschikbaarheid zelf vormt nog geen bruikbare alternatieve inkooproute. Een wederverkoper kan een product technisch misschien via de consumentenwebsite bestellen, maar daarmee is nog niet aangetoond dat die transactie bedrijfseconomisch zinvol is. De consumentenprijs bevat al de marge en retailkosten van de leverancier en laat voor een tweede verkoper meestal weinig ruimte over. Wie vervolgens hetzelfde product tegen een concurrerende marktprijs wil aanbieden, moet uit die resterende ruimte nog zijn eigen kosten financieren.
Daarbij gaat het niet alleen om het eenvoudige verschil tussen inkoop- en verkoopprijs. Btw, verzending, betaalproviderkosten, platformkosten, marketinguitgaven, klantenservice en retourrisico bepalen samen of een product commercieel verantwoord verkocht kan worden. Zeker bij producten met relatief hoge retourkosten kan een theoretisch positieve brutomarge in de praktijk onvoldoende zijn om het verkooprisico te dragen. Beschikbaarheid moet daarom minstens twee vragen beantwoorden: kan het product daadwerkelijk worden ingekocht en kan het vervolgens verantwoord worden doorverkocht?
Een product is voor een retailer pas werkelijk beschikbaar wanneer het zowel leverbaar als commercieel verantwoord inkoopbaar is.
Dat verschil wordt gemakkelijk gemist wanneer productdata en marketing los van financiële logica worden beheerd. Een marketeer ziet een populair model en wil het zo snel mogelijk vindbaar maken, een feedmanager ziet een URL waarop voorraad staat en de klant ziet uiteindelijk een koopknop. Pas wanneer iemand de volledige keten bekijkt, wordt zichtbaar dat dezelfde verkoop tegen de actuele marktprijs nauwelijks ruimte kan laten voor de kosten die tussen bestelling en levering ontstaan. Technische beschikbaarheid is daarom geen synoniem voor commerciële beschikbaarheid.
Nieuwe collecties laten zien waar de supply chain de marketing inhaalt
Bij nieuwe productcollecties wordt het probleem nog scherper. Tijdens dezelfde assortimentsanalyse bleken modellen uit een nieuwe collectie al zichtbaar op de consumentenwebsite van de leverancier en bij verschillende concurrenten, terwijl ze via het reguliere zakelijke kanaal nog niet of slechts beperkt beschikbaar waren. Dat is geen klassieke voorraadfout. De zakelijke feed kan volledig correct aangeven dat het eigen account het artikel nog niet kan bestellen, terwijl andere marktpartijen het product ondertussen al actief verkopen.
Voor een gespecialiseerde webshop ontstaat dan een strategische achterstand die niet met een snellere synchronisatie kan worden opgelost. Concurrenten kunnen hun productpagina’s eerder laten indexeren, advertenties activeren, reviews verzamelen en de eerste zoekvraag naar een nieuw model opvangen. Wanneer het eigen B2B-kanaal het product pas later vrijgeeft, begint de commerciële introductie dus niet op hetzelfde moment. De supply chain bepaalt in dat geval letterlijk wanneer marketing kan beginnen.
[AFBEELDING 4 – geanonimiseerde screenshot van een nieuwe collectie of modelreeks die in een consumenten- of marktcontext al zichtbaar is terwijl de reguliere zakelijke inkoopstatus nog ontbreekt of beperkt is. Verwijder bedrijfs- en leveranciersidentificatie; laat de launch-gap zelf zichtbaar.]
Dat betekent niet dat een bestaande hoofdleverancier daardoor ongeschikt wordt. Voor lopende modellen kan dezelfde partij juist aantrekkelijke B2B-prijzen, brede beschikbaarheid en operationeel gemak bieden. Wel ontstaat een reden om productlanceringen als afzonderlijke inkoopcategorie te behandelen. De beste leverancier voor een volwassen assortiment hoeft niet automatisch ook de beste route te zijn voor de eerste weken van een nieuwe collectie.
Voor nieuwe productintroducties moet een retailer daarom afzonderlijk beoordelen:
- wanneer de daadwerkelijke zakelijke dealerrelease start;
- welke nieuwe modellen commercieel belangrijk genoeg zijn om vroeg beschikbaar te hebben;
- of een aanvullende distributeur of directe dealerrelatie voor launches nodig is;
- wanneer reguliere B2B-inkoop aantrekkelijker wordt dan vroege beschikbaarheid.
Een kleine of middelgrote gespecialiseerde webshop hoeft daarvoor niet meteen iedere nieuwe collectie volledig op voorraad te nemen. Het kan voldoende zijn om bij introductie een beperkt aantal modellen te selecteren waarvoor aantoonbare vraag bestaat, terwijl de rest later via het reguliere B2B-kanaal wordt toegevoegd. Daarmee wordt de leveranciersstructuur niet onnodig complex, maar wordt wel voorkomen dat één distributiekanaal automatisch het marktintroductiemoment van het volledige assortiment bepaalt.
De productfeed is niet het begin van de keten
Veel discussies over e-commerce-integratie beginnen bij de vraag hoe een productfeed moet worden ingericht. Dat is begrijpelijk, omdat de feed de zichtbare technische koppeling vormt tussen systemen. Commercieel gezien begint het proces echter veel eerder. Voordat een artikel veilig door een feed kan worden verspreid, moeten productidentiteit, brondata, zakelijke beschikbaarheid, inkoopprijs en marge voldoende betrouwbaar zijn vastgesteld.
Een technisch perfecte feed kan geen ontbrekend artikelnummer reconstrueren dat de leverancier zelf niet consequent publiceert. Hij kan evenmin bepalen dat B2C-voorraad voor een bepaald account niet zakelijk beschikbaar is, tenzij die logica expliciet in de data of in een tussenlaag wordt vastgelegd. Een voorraadfeed kan bovendien niet zelfstandig beoordelen of een product met een bepaalde inkoopprijs nog voldoende marge biedt nadat btw, verzending en retourrisico zijn meegenomen. Zulke beslissingen liggen vóór de distributie van de data.
Daarom is de kwaliteit van een e-commerce-integratie niet alleen afhankelijk van API’s, CSV-bestanden of synchronisatiefrequentie. Minstens zo belangrijk is de kwaliteit van het datamodel waarmee uitzonderingen worden beheerd. Welke bron is leidend wanneer twee systemen elkaar tegenspreken? Welke producten mogen nooit automatisch worden geactiveerd zonder zakelijke voorraad? Welke nieuwe modellen vereisen eerst een margecontrole, en hoe wordt voorkomen dat een handmatig gecorrigeerde uitzondering bij de volgende import opnieuw wordt overschreven?
Pas wanneer die vragen zijn beantwoord, krijgt automatisering haar werkelijke waarde. Dan neemt zij betrouwbaar repetitief werk over in plaats van onzekerheid sneller door de keten te verspreiden. Dat verschil is fundamenteel voor iedere webshop die afhankelijk is van externe leveranciers en honderden producten beheert. Schaalbaarheid ontstaat niet doordat er zoveel mogelijk wordt geautomatiseerd, maar doordat duidelijk is welke gegevens betrouwbaar genoeg zijn om zonder menselijke tussenkomst te automatiseren.
Marketingexpertise houdt niet op bij de voorkant van de webshop
Deze praktijkcase legt ook een bredere beperking bloot in de manier waarop digitale marketing vaak wordt afgebakend. Het vak wordt gemakkelijk teruggebracht tot campagneplatforms, content, dashboards en conversie-optimalisatie. Dat zijn zichtbare onderdelen waarop resultaten relatief eenvoudig kunnen worden gerapporteerd, maar in e-commerce vertegenwoordigen ze slechts een deel van het commerciële systeem. Een campagne die omzet genereert voor een product dat vervolgens niet leverbaar blijkt, is vanuit de advertentie-interface misschien succesvol maar voor de onderneming als geheel niet.
Dat betekent niet dat iedere marketeer zelf API’s moet programmeren, voorraadbestanden moet opschonen of internationale inkoopcontracten moet beheren. Wel mag van iemand die verantwoordelijkheid draagt voor e-commerce worden verwacht dat hij begrijpt hoe die onderdelen de marketingprestatie begrenzen. Een stijgend conversiepercentage zegt weinig wanneer tegelijkertijd meer bestellingen moeten worden geannuleerd. Een productfeed met honderd procent technisch geldige velden is evenmin betrouwbaar wanneer de voorraadbron commercieel verkeerd wordt geïnterpreteerd.
Juist daar ontstaat het verschil tussen het bedienen van marketingtools en het begrijpen van het systeem waarin die tools functioneren. De techniek hoeft niet volledig door één persoon te worden uitgevoerd, maar iemand moet wel herkennen wanneer een probleem buiten de advertentie-interface ontstaat en welke discipline nodig is om het op te lossen. Soms ligt de oorzaak in productdata, soms in voorraadsegmentatie, soms in marge en soms in de structuur van de leveranciersrelatie. Wie alleen naar de voorkant kijkt, ziet de symptomen pas nadat de klant ermee wordt geconfronteerd.
Voor organisaties die e-commerce willen opschalen is dat geen theoretische nuance. Naarmate assortiment, landen, leveranciers en verkoopkanalen groeien, neemt het aantal afhankelijkheden sneller toe dan het aantal zichtbare pagina’s in de webshop. Een handmatige uitzondering die bij honderd producten nog beheersbaar is, kan bij duizend producten een structurele foutbron worden. Schaalbaarheid begint daarom niet uitsluitend met meer verkeer of meer automatisering, maar met een datamodel en supply chain die de extra commerciële druk aankunnen.
De klant merkt uiteindelijk iedere fout in de keten
De klant hoeft niets te weten over SKU’s, EAN-codes, mappingtabellen, B2B-portalen of voorraadfeeds. Dat is ook niet zijn verantwoordelijkheid. Hij ziet een product, krijgt een beschikbaarheidsbelofte en verwacht dat een bestelling vervolgens wordt uitgevoerd. Precies daarom moet de complexiteit achter de schermen vóór die koopknop worden opgelost en niet erna.
Voor marketeers en e-commerceprofessionals is dat misschien de belangrijkste les uit deze praktijkcase. Datakwaliteit is geen intern technisch onderwerp zolang slechte data bepalen welke producten worden geadverteerd, verkocht of geannuleerd. Leveranciersstrategie is geen puur inkoopvraagstuk wanneer de gekozen distributieroute bepaalt of een nieuwe collectie weken eerder of later op de markt kan worden gebracht. En voorraadbeheer is geen backofficeactiviteit wanneer een verkeerde status rechtstreeks invloed heeft op klantvertrouwen, acquisitiekosten en marge.
De voorkant van e-commerce bepaalt hoe overtuigend een product wordt gepresenteerd en verkocht. De achterkant bepaalt of die commerciële belofte daadwerkelijk kan worden waargemaakt. Wie alleen advertenties, content en conversie optimaliseert zonder de kwaliteit van productdata, voorraad en inkoopvoorwaarden mee te nemen, optimaliseert uiteindelijk slechts een deel van het systeem. Sterker nog: hoe beter de marketing presteert, hoe sneller een zwakke supply chain zichtbaar wordt wanneer extra vraag niet betrouwbaar kan worden vervuld.
De meest volwassen vorm van e-commercemarketing begint daarom niet bij de vraag hoeveel extra verkeer een campagne kan genereren, maar bij een fundamentelere controle: kan de organisatie de vraag die zij zelf creëert betrouwbaar, winstgevend en zonder onnodige frictie vervullen? Pas wanneer productdata, zakelijke beschikbaarheid, marge en levering op elkaar aansluiten, krijgt marketing aan de voorkant de waarde die dashboards eraan toeschrijven.


